フリーランスエンジニアの稼働記録・工数管理をPythonで自動化!gspread×Googleスプレッドシート実践ガイド
「今月、あのプロジェクトに何時間使ったんだっけ…?」
フリーランスで複数案件を並行していると、この一言が月末に必ずやってきますよね😅 稼働記録をつけているつもりでも、メモアプリとカレンダーとSlackの履歴に散らばっていて、請求書を作る前日に慌てて掘り起こす——そんな経験、心当たりありませんか?
今回は、Python+gspread+Googleスプレッドシートで稼働記録の入力から月次集計・請求額の算出までをまるっと自動化する方法を、コピペで動くコード付きで解説します。ローカルのExcelファイルではなくクラウド(スプレッドシート)を記録先にするのがポイントです。外出先のスマホからも同じ表を見られるので、工数管理が一気に現実的になります。
- 難易度:★★☆(Python初〜中級者向け)
- 所要時間:初回セットアップ約30分+コード写経
- 必要なもの:Pythonの実行環境/Googleアカウント
なぜExcelではなくスプレッドシート×gspreadなのか
工数管理をPythonで自動化する方法はいくつかありますが、記録先の選択で運用のラクさがかなり変わります。ざっくり比較するとこんな感じです。
- ローカルのExcel(openpyxl):オフラインで速い。ただしPCを開かないと入力も閲覧もできない
- CSV+自作ツール:軽いが、クライアントに共有しづらい
- Googleスプレッドシート(gspread):スマホから入力・閲覧OK。クライアントへの共有もURL1本。Pythonからも読み書き自由
つまり「入力はスマホからでも手打ちでも、集計はPythonで一瞬」というハイブリッド運用ができるのが最大のメリットです。稼働記録って、結局「入力し続けられるか」がすべてなんですよね。
STEP1:サービスアカウントを作ってシートを共有する
gspreadからスプレッドシートを操作するには、サービスアカウント(プログラム用のGoogleアカウントのようなもの)を用意します。流れはこうです。
- Google Cloudでプロジェクトを作成
- 「Google Sheets API」と「Google Drive API」を有効化
- サービスアカウントを作成し、鍵(JSON)をダウンロード
- JSON内の
client_email(〜@〜.iam.gserviceaccount.com)を確認 - 工数管理用スプレッドシートを作り、そのメールアドレスに編集者権限で共有
5番目の共有を忘れると、あとで APIError(403 PERMISSION_DENIED)が出ます。シートIDではなくシート名で open() した場合は SpreadsheetNotFound になります。いずれも原因は「共有し忘れ」なので、ここは必ず確認しておきましょう✅
ダウンロードしたJSONは service_account.json という名前でプロジェクト直下に置きます。Gitには絶対に入れないので、.gitignore への追記も忘れずに。
STEP2:gspreadをインストールして接続確認
pip install gspread google-auth pandasシートは「稼働記録」という名前のワークシートを作り、1行目に見出しを入れておきます。
- A列:日付
- B列:案件名
- C列:作業内容
- D列:開始
- E列:終了
- F列:稼働時間
準備ができたら、接続できるか確かめます。
import gspread
from google.oauth2.service_account import Credentials

# Sheets と Drive の両方のスコープが必要
SCOPES = [
    "https://www.googleapis.com/auth/spreadsheets",
    "https://www.googleapis.com/auth/drive",
]
SHEET_KEY = "ここにスプレッドシートIDを貼る"  # URLの /d/ と /edit の間

def get_worksheet(name="稼働記録"):
    creds = Credentials.from_service_account_file("service_account.json", scopes=SCOPES)
    gc = gspread.authorize(creds)
    return gc.open_by_key(SHEET_KEY).worksheet(name)

if __name__ == "__main__":
    ws = get_worksheet()
    print("接続OK:", ws.title)
    for row in ws.get_all_records()[:3]:
        print(row)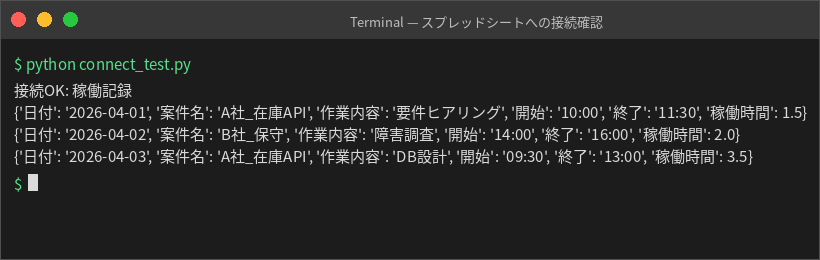
ポイントをまとめるとこんな感じです。
get_all_records()は1行目を見出しとして辞書のリストを返してくれる(pandasに渡しやすい)- スプレッドシートIDはURLの
/d/と/editの間の長い文字列 - 関数化しておくと、後続スクリプトから使い回せる
STEP3:稼働1件をワンコマンドで記録する
次に、稼働を1行追記する関数を作ります。手入力の手間をどこまで削れるかが続けられるかの分かれ目なので、引数は最小限にします。
from datetime import datetime, timedelta
from connect_test import get_worksheet  # STEP2の関数を再利用

def add_log(project, task, start, end):
    """稼働記録を1行追記する"""
    minutes = (end - start).total_seconds() / 60
    hours = round(minutes / 60, 2)  # 小数2桁の時間に変換

    ws = get_worksheet()
    ws.append_row([
        start.strftime("%Y-%m-%d"),
        project,
        task,
        start.strftime("%H:%M"),
        end.strftime("%H:%M"),
        hours,
    ], value_input_option="USER_ENTERED")
    return hours

if __name__ == "__main__":
    s = datetime(2026, 4, 10, 10, 0)
    e = datetime(2026, 4, 10, 12, 30)
    print(f"記録しました: {add_log('A社_在庫API', '認証まわり実装', s, e)}時間")
value_input_option="USER_ENTERED" を付けると、シートにブラウザから手入力したときと同じように、スプレッドシート側が日付や時刻として解釈してくれます。ここを省くと既定の RAW になり、「2026-04-10」や「10:00」が日付・時刻ではなくただの文字列としてセルに入ります。後で日付でフィルタしたいときに地味に困るので要注意です⚠️
STEP4:CLIタイマーで「開始」「終了」を打つだけにする
時刻を毎回手で書くのは続きません。そこで、start と stop の2コマンドだけで完結するタイマーにします。状態はローカルのJSONに持たせるだけでOKです。
import json, os, sys
from datetime import datetime
from log_work import add_log

STATE = ".timer_state.json"

def start(project, task):
    if os.path.exists(STATE):
        print("⚠️ すでに計測中です。先に stop してください")
        return
    data = {
        "project": project,
        "task": task,
        "start": datetime.now().isoformat(timespec="seconds"),
    }
    with open(STATE, "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False)
    print(f"▶ 計測開始: {project} / {task}")

def stop():
    if not os.path.exists(STATE):
        print("計測中のタスクがありません")
        return
    with open(STATE, encoding="utf-8") as f:
        data = json.load(f)
    s = datetime.fromisoformat(data["start"])
    e = datetime.now()
    hours = add_log(data["project"], data["task"], s, e)
    os.remove(STATE)
    print(f"■ 計測終了: {hours}時間 をシートに記録しました")

if __name__ == "__main__":
    cmd = sys.argv[1]
    if cmd == "start":
        start(sys.argv[2], sys.argv[3])
    else:
        stop()
使い方はこれだけです。
python timer.py start "A社_在庫API" "設計レビュー"- 作業が終わったら
python timer.py stop
「打刻を忘れる」問題は、エイリアス(alias ws="python ~/tools/timer.py")を切って、ターミナルを開いたら最初に叩く癖をつけるのがおすすめです。
STEP5:月次集計でプロジェクト別の工数と請求額を出す
ここからがPythonの本領発揮です。シートを丸ごと読んでpandasで集計し、案件別の稼働時間・請求額・予算消化率を一気に算出します。
import pandas as pd
from connect_test import get_worksheet

# 案件ごとの単価と月間契約時間
CONTRACTS = {
    "A社_在庫API": {"rate": 6000, "budget": 60},
    "B社_保守":     {"rate": 5000, "budget": 20},
    "自社サービス": {"rate": 0,    "budget": 30},
}

def monthly_report(year_month="2026-04"):
    df = pd.DataFrame(get_worksheet().get_all_records())
    df["日付"] = pd.to_datetime(df["日付"])
    df["稼働時間"] = pd.to_numeric(df["稼働時間"], errors="coerce").fillna(0)

    # 対象月だけ抽出
    target = df[df["日付"].dt.strftime("%Y-%m") == year_month]

    g = target.groupby("案件名")["稼働時間"].sum().reset_index()
    g["単価"]   = g["案件名"].map(lambda p: CONTRACTS.get(p, {}).get("rate", 0))
    g["請求額"] = (g["稼働時間"] * g["単価"]).astype(int)
    g["契約時間"] = g["案件名"].map(lambda p: CONTRACTS.get(p, {}).get("budget", 0))
    # 契約時間が0の案件(CONTRACTS未登録など)は 0除算で inf になるため 0 扱いにする
    g["消化率%"] = (g["稼働時間"] / g["契約時間"].where(g["契約時間"] > 0) * 100).round(1).fillna(0)
    return g.sort_values("請求額", ascending=False)

if __name__ == "__main__":
    rep = monthly_report("2026-04")
    print(rep.to_string(index=False))
    print(f"\n合計請求額: {rep['請求額'].sum():,} 円")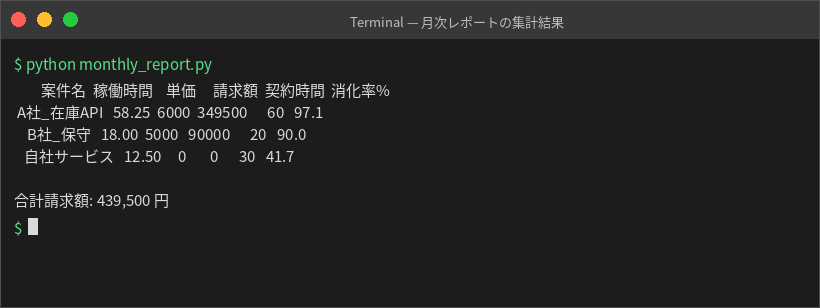
ここが重要です。
- 単価と契約時間はコード側に辞書で持つ(シートに書くと誤操作で壊れやすい)
pd.to_numeric(..., errors="coerce")で手入力の全角文字などを無害化- 契約時間が0の案件をそのまま割ると
infになり、STEP6でシートに書き戻す際にエラーの原因になるので0埋めしておく - 消化率を見れば「今月このままだと超過する」が月中でも分かる
この消化率、地味ですが効きます。月末に「20時間オーバーしてたけど請求できない」という事故を防げるんですよね。
STEP6:集計結果をシートに書き戻す
ターミナルで見るだけではもったいないので、「月次サマリ」ワークシートに書き戻しましょう。クライアントにそのまま共有できる状態になります。
from connect_test import get_worksheet
from monthly_report import monthly_report
import gspread

def write_summary(year_month="2026-04"):
    rep = monthly_report(year_month)
    try:
        ws = get_worksheet("月次サマリ")
    except gspread.WorksheetNotFound:
        ws = get_worksheet().spreadsheet.add_worksheet("月次サマリ", rows=100, cols=10)

    values = [[f"{year_month} 稼働レポート"]]
    values.append(rep.columns.tolist())
    values += rep.values.tolist()
    values.append(["合計", float(rep["稼働時間"].sum()), "", int(rep["請求額"].sum()), "", ""])

    ws.clear()
    ws.update(values, "A1", value_input_option="USER_ENTERED")
    ws.format("A2:F2", {"textFormat": {"bold": True}})
    print("月次サマリを更新しました")

if __name__ == "__main__":
    write_summary("2026-04")
ws.update() に二次元リストを渡すと1回のAPIリクエストでまとめて書き込みできます。1セルずつ update_cell() で回すのはNGです(理由は次で説明します)。なお update() の引数順は gspread 6系の update(values, range_name) を前提にしています(5系は逆順なので、バージョンを跨ぐ場合は values= / range_name= とキーワードで渡すのが安全です)。
APIのレート制限でコケないための2つのコツ
gspreadで最初にハマるのが APIError: [429] Quota exceeded です。Google Sheets APIには1分あたりのリクエスト数制限があるため、ループ内で1行ずつ書くとすぐ引っかかります。
# ❌ 悪い例:100回リクエストが飛ぶ
for row in rows:
    ws.append_row(row)

# ✅ 良い例:1回のリクエストでまとめて追記
ws.append_rows(rows, value_input_option="USER_ENTERED")

# ✅ 読み込みも同じ。都度 get ではなく一括で取得してメモリ上で処理する
records = ws.get_all_records()
覚えておきたいのはこの2点だけです。
- 書き込みは
append_rows/updateでまとめる - 読み込みは最初に1回、あとはpandasで処理する
それでも429が出る場合は、リトライを挟むか、集計処理を1日1回のバッチ(cronやタスクスケジューラ)に寄せてしまうのが現実的です。
ここまでできたら試したい応用ネタ
- 消化率が90%を超えたらLINEやSlackに通知(超過前に単価交渉の材料にできる)
- 作業内容の文字列を集計して「実装/打ち合わせ/調査」の比率を可視化
- 月次サマリをそのままCSV出力して、請求書テンプレートに流し込む
- 案件名をシートのプルダウンにして入力ゆれを防止(表記ゆれは集計の天敵です)
特に最後の「表記ゆれ対策」は効果が大きいです。「A社_在庫API」と「A社 在庫API」が混ざると、groupbyで別案件として集計されてしまいます。入力側で潰しておきましょう。
まとめ
今回は、フリーランスエンジニアの稼働記録・工数管理をPythonとgspreadで自動化する方法を、サービスアカウントの準備からCLIタイマー、月次集計、シートへの書き戻しまで通しで解説しました。
- 記録先をGoogleスプレッドシートにすると、スマホ入力とPython集計を両立できる
start/stopの2コマンドまで簡略化すると記録が続く- pandasで案件別の稼働時間・請求額・消化率を一発算出
- APIリクエストは「まとめて読む・まとめて書く」が鉄則
工数管理は地味な作業ですが、数字が見えるようになると「その案件、本当に採算取れてる?」という判断が一瞬でできるようになります。月末の1〜2時間を取り戻すだけでも十分元が取れるはずです。
まずはSTEP2の接続確認だけでもやってみてください。シートに1行書き込めた瞬間、「むずかしそう」が「できそう」に変わりますよ😊 一緒に業務効率化を進めていきましょう!
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR