PythonでCSVの文字化けを一括解決!cp932・UTF-8を判定してExcelで開ける形式に変換
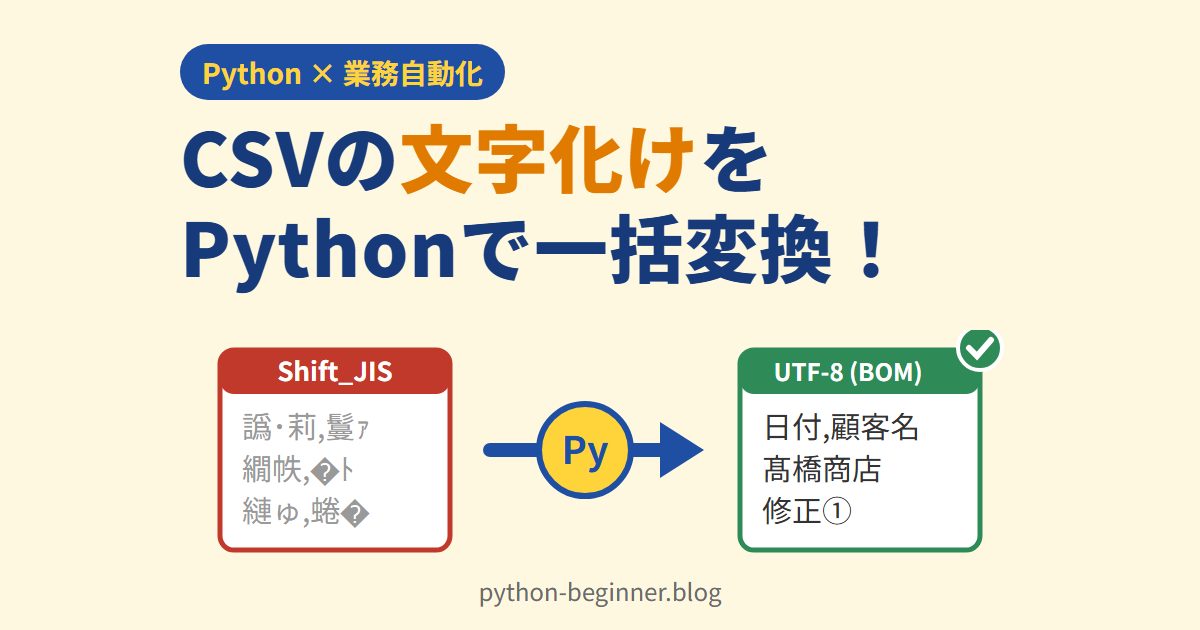
「取引先からもらったCSVを開いたら、日本語が全部『譌・莉…』みたいな読めない文字になった」
「Pythonで読み込もうとしたら UnicodeDecodeError で止まってしまう」
こんな経験、ありませんか? 請求データや売上一覧をCSVでやりとりしていると、一度はぶつかる壁ですよね。
この記事では、CSVの文字コードをPythonで判定して、ExcelでもPythonでも文字化けしない形式に一括変換するスクリプトを作ります。対象は、open() と for 文がわかる初〜中級者の方です。フォルダにCSVを放り込んで実行するだけで変換できるところまで、一緒に見ていきましょう!
そもそも文字化けはなぜ起きる?
パソコンの中では、文字は「バイト(数字の並び)」として保存されています。どの数字をどの文字に対応させるかのルールが文字コードです。
イメージとしては、同じ暗号文を、違う暗号表で読もうとしている状態です。書いた側と読む側の暗号表がずれると、意味のない記号が並んでしまいます。
日本のCSVでよく出会う文字コードは、次の3つです。
| 文字コード | よく出てくる場面 | Pythonでの指定 |
|---|---|---|
| Shift_JIS(Windows版) | 日本語版Excelで「CSV(コンマ区切り)」保存したファイル、古い業務システム | cp932 |
| UTF-8(BOMなし) | Webサービスの書き出し、Mac・Linux、Pythonの標準 | utf-8 |
| UTF-8(BOM付き) | Excelの「CSV UTF-8(コンマ区切り)」保存 | utf-8-sig |
BOMは、ファイルの先頭に付く「これはUTF-8ですよ」という3バイトの目印です。日本語版のExcelはCSVをダブルクリックで開くとき、この目印がないとShift_JISとして読もうとすることがあり、UTF-8のCSVが文字化けする原因になります。
つまり、「BOM付きUTF-8」にそろえておけば、ExcelでもPythonでも読みやすいというわけです。
練習用のCSVを4種類作る
まずは中身が同じで文字コードだけ違うCSVを作ります。あえて「髙」(はしごだか)や「①」「~」のような、トラブルになりやすい文字を入れています。
# 練習用のCSVを4種類の文字コードで作る
from pathlib import Path

rows = "日付,顧客名,品目,金額\n2026-10-01,髙橋商店,ホームページ修正①,55000\n2026-10-15,山田~デザイン,バナー制作,22000\n"
folder = Path("input")
folder.mkdir(exist_ok=True)
(folder / "sales_sjis.csv").write_text(rows, encoding="cp932")      # Excelで普通に保存した想定
(folder / "sales_utf8.csv").write_text(rows, encoding="utf-8")      # Webサービスから出力した想定
(folder / "sales_bom.csv").write_text(rows, encoding="utf-8-sig")   # BOM付きUTF-8
(folder / "sales_utf16.csv").write_text(rows, encoding="utf-16")    # 一部のツールが出すUTF-16
print("サンプルを4つ作成しました")
実行すると input フォルダに4つのCSVができます。どれも見た目は同じ表ですが、中のバイトはまったく違います。
shift_jis と cp932 は別物! 読み比べてみる
Excelで作ったCSV(sales_sjis.csv)を、3つの文字コードで読んでみます。ここで質問です。これ、実行せずに答えられますか? 「shift_jis」で読むと成功するでしょうか?
# 同じCSVを、いろいろな文字コードで読んでみる
from pathlib import Path

path = Path("input/sales_sjis.csv")
data = path.read_bytes()  # まずはバイト列のまま読み込む

for enc in ["utf-8", "shift_jis", "cp932"]:
    try:
        text = data.decode(enc)
        print(f"{enc:10} → 成功: {text.splitlines()[1]}")
    except UnicodeDecodeError as e:
        print(f"{enc:10} → 失敗: {e.reason}({e.start}バイト目)")
ポイントをまとめるとこんな感じです👇
read_bytes()で、文字に変換する前のバイト列のまま読み込むbytes.decode(文字コード)で変換を試し、失敗したらUnicodeDecodeErrorをつかまえるe.startで、何バイト目でつまずいたかがわかる
実行結果はこうなりました。
utf-8      → 失敗: invalid start byte(0バイト目)
shift_jis  → 失敗: illegal multibyte sequence(34バイト目)
cp932 → 成功: 2026-10-01,髙橋商店,ホームページ修正①,55000意外なことに、shift_jis では失敗しています。34バイト目は「髙」の位置です。
実はPythonの shift_jis は元の規格どおりの文字しか扱えず、Windowsが追加した「髙」「①」や、Windowsでよく使われる「~」(全角チルダ)は読めません。Windows・Excel由来のCSVは cp932 を指定するのが正解です。ここが重要です⚠️
フォルダ内のCSVを一括変換するスクリプト
いよいよ本題です。input フォルダのCSVの文字コードを1つずつ判定して、output フォルダにBOM付きUTF-8で書き出します。
# input フォルダのCSVを、Excelで文字化けしない UTF-8(BOM付き)に一括変換する
from pathlib import Path

INPUT_DIR = Path("input")
OUTPUT_DIR = Path("output")
# 試す順番が大事:BOM付き → BOMなしUTF-8 → Windowsの日本語(cp932)
CANDIDATES = ["utf-8-sig", "utf-8", "cp932"]


def detect_encoding(data: bytes) -> str | None:
    """デコードに成功した最初の文字コードを返す(全部ダメなら None)"""
    if data.startswith(b"\xef\xbb\xbf"):
        return "utf-8-sig"
    if data.startswith((b"\xff\xfe", b"\xfe\xff")):
        return "utf-16"  # 先頭の印(BOM)でUTF-16と判定する
    for enc in CANDIDATES[1:]:
        try:
            data.decode(enc)
            return enc
        except UnicodeDecodeError:
            continue
    return None


def main() -> None:
    OUTPUT_DIR.mkdir(exist_ok=True)
    for path in sorted(INPUT_DIR.glob("*.csv")):
        data = path.read_bytes()
        enc = detect_encoding(data)
        if enc is None:
            print(f"[要確認] {path.name}: 文字コードを判定できません")
            continue

        text = data.decode(enc)
        out_path = OUTPUT_DIR / path.name
        # newline="" で改行コードをそのまま保つ(空行が増えるのを防ぐ)
        with open(out_path, "w", encoding="utf-8-sig", newline="") as f:
            f.write(text)
        lines = text.splitlines()
        # 1行目(見出し)を表示して、化けていないか目で確認できるようにする
        print(f"[変換] {path.name}: {enc} → utf-8-sig({len(lines)}行) 見出し: {lines[0]}")


if __name__ == "__main__":
    main()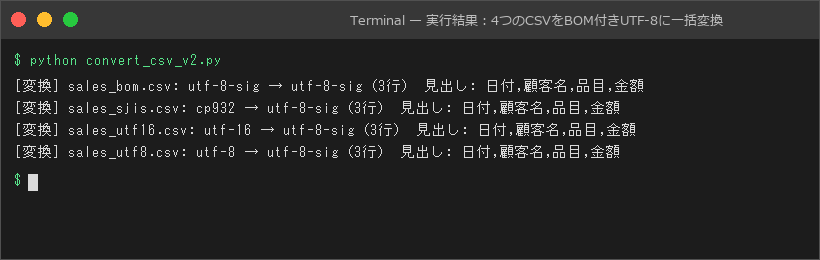
ここが重要です👇
- 判定する順番が大事。先に目印(BOM)で確実にわかるものを判定し、次に
utf-8、最後にcp932を試します。UTF-8は規則が厳しいので、Shift_JISのファイルがUTF-8として「たまたま読めてしまう」ことはまずありません - 書き出しは
encoding="utf-8-sig"にすると、自動でBOMが付きます newline=""を付けないと、Windowsでは改行コードが二重になり、Excelで空行が増えることがあります- 1行目(見出し)を表示しておくと、化けていないかを目で確認できます
実行結果です。4つとも見出しが正しく読めています😊
[変換] sales_bom.csv: utf-8-sig → utf-8-sig(3行) 見出し: 日付,顧客名,品目,金額
[変換] sales_sjis.csv: cp932 → utf-8-sig(3行) 見出し: 日付,顧客名,品目,金額
[変換] sales_utf16.csv: utf-16 → utf-8-sig(3行) 見出し: 日付,顧客名,品目,金額
[変換] sales_utf8.csv: utf-8 → utf-8-sig(3行) 見出し: 日付,顧客名,品目,金額
つまずきポイント:UTF-16のファイルが「要確認」になった
実は最初、detect_encoding() にUTF-16の判定(b"ÿþ" の行)を入れていませんでした。そのときの結果がこちらです。
[要確認] sales_utf16.csv: 文字コードを判定できませんUTF-16は1文字を2バイト以上で表す方式で、UTF-8でもcp932でも読めません。一部のツールやExcelの「Unicode テキスト」保存ではこの形式になることがあります。UTF-16のファイルには通常、先頭にBOM(FF FE など)が付いているので、その目印で判定を足したら変換できるようになりました。
このように、判定できないファイルは無理に変換せず「要確認」で止める作りにしておくと、知らないうちにデータを壊す心配がありません。
ただし注意点もあります。cp932 は読めるバイトの範囲が広いので、本当は別の文字コードのファイルでも「成功」してしまうことがあります。変換後に表示される見出しを、必ず確認しましょう。
まとめ
- 文字化けは「書いた側と読む側の文字コードのずれ」で起きる
- Windows・Excel由来のCSVは
shift_jisではなくcp932で読む - 判定は「BOM → utf-8 → cp932」の順。判定できないファイルは止めて目で確認する
- 書き出しは
encoding="utf-8-sig"とnewline=""で、ExcelでもPythonでも開きやすくなる
取引先ごとにバラバラな形式のCSVも、このスクリプトを通せば同じ形にそろいます。「文字化けはむずかしそう」を「これで直せそう」に変えるきっかけになればうれしいです。ぜひ手元のCSVで試してみてください🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR