AIが書いたPythonコードの遅さに気づくには|同じ答えでも手順で速さが変わる例と見抜き方
「AIに書いてもらったコード、ちゃんと動いたからOK…で、いいんだよね?」
「データが増えたら急に終わらなくなった。どこが悪いのか分からない…」
こんな経験、ありませんか? AIが書いたコードは、たいてい答えは合っています。でも「答えが合っている」と「速い」は別の話です。同じ答えを出すコードでも、手順(アルゴリズム)が違うだけで、速さが何百倍も変わることがあります。
この記事では、Pythonの標準機能だけで「同じ答えなのに速さが全然違う」例を2つ実際に測り、そのあと遅いコードを見抜く方法を2つ紹介します。対象は、for文・リスト・集合・関数を読める方です。一緒に見ていきましょう!
例1:重複を探すとき「リスト」で覚えるか「集合」で覚えるか
数のリストから、2回以上出てくる数を探すコードです。AIに頼むと、どちらの書き方もよく出てきます。違いは、「もう見た数」をリストで覚えるか、集合(set)で覚えるかだけです。
import random
import time


def find_dups_list(nums):
    """見たことのある数を「リスト」で覚える版"""
    seen = []
    dups = []
    for n in nums:
        if n in seen:          # リストの in は、先頭から1つずつ見比べる
            dups.append(n)
        else:
            seen.append(n)
    return dups


def find_dups_set(nums):
    """見たことのある数を「集合(set)」で覚える版"""
    seen = set()
    dups = []
    for n in nums:
        if n in seen:          # set の in は、データが増えてもほぼ一瞬
            dups.append(n)
        else:
            seen.add(n)
    return dups


random.seed(0)
for size in [5000, 10000, 20000]:
    nums = [random.randint(1, size * 10) for _ in range(size)]
    t0 = time.perf_counter()
    a = find_dups_list(nums)
    t1 = time.perf_counter()
    b = find_dups_set(nums)
    t2 = time.perf_counter()
    print(f"{size:>6}件  リスト版 {t1 - t0:7.3f}秒  set版 {t2 - t1:7.4f}秒  答えが同じ: {a == b}")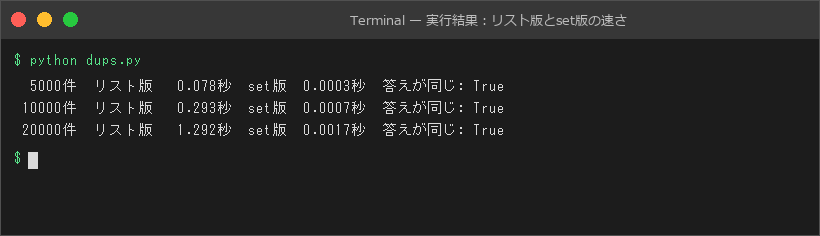
どちらも答えは同じ(True)です。でも 20,000 件では、リスト版が1秒以上かかるのに、set版は 0.002 秒ほど。件数が2倍になるたびに、リスト版はおよそ4倍ずつ遅くなっています(時間は筆者のパソコンでの一例です)。
ここが重要です👇
- リストの
inは、先頭から1つずつ見比べる。覚えた数が増えるほど、1回の確認が長くなる - それを for文の中で毎回やるので、実質は二重ループ。件数が2倍なら、時間はおよそ 2×2=4倍
- 集合の
inは、中身が増えてもほぼ一定の時間で答えが出る。だから全体でも件数に比例するだけで済む
例2:同じ計算を何百万回もくり返す再帰
もう1つは、フィボナッチ数(前の2つを足していく数列)です。「再帰で書いて」と頼むと、定義どおりの短いコードが返ってきます。
import time
from functools import cache

calls = 0


def fib(n):
    """そのまま再帰で書いたフィボナッチ数"""
    global calls
    calls += 1
    if n < 2:
        return n
    return fib(n - 1) + fib(n - 2)


@cache                      # 一度計算した答えを覚えておく(メモ化)
def fib_memo(n):
    if n < 2:
        return n
    return fib_memo(n - 1) + fib_memo(n - 2)


for n in [20, 25, 30]:
    calls = 0
    t0 = time.perf_counter()
    a = fib(n)
    fib_memo.cache_clear()      # 前の n で覚えた答えを消して、公平に測る
    t1 = time.perf_counter()
    b = fib_memo(n)
    t2 = time.perf_counter()
    print(f"n={n}  答え {a}  再帰版 {t1 - t0:6.3f}秒(呼び出し {calls:,}回)  メモ化版 {t2 - t1:.5f}秒  同じ: {a == b}")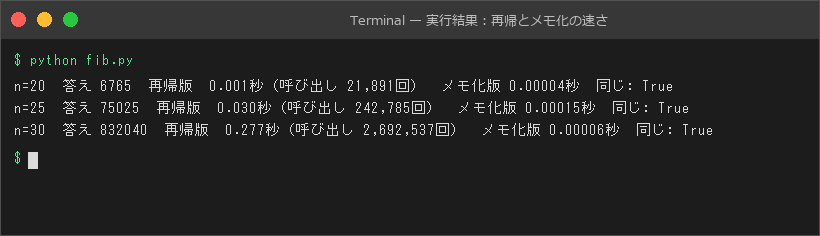
n が 5 増えるだけで、再帰版の呼び出し回数は約11倍に増えています。n=30 では 269万回。答えは 832040 なので、同じ計算を何度も何度もやり直しているわけです。
たとえば fib(30) は fib(29) と fib(28) を呼び、fib(29) がまた fib(28) を呼ぶ…と、同じ引数の計算が枝分かれして何度も出てきます。@cache(メモ化)で一度出した答えを覚えておけば、それぞれの n は1回ずつ計算するだけで済みます。
これ、実行せずに答えられますか? 再帰版で n を 40 にしたら、何秒くらいかかるでしょう。5 増えるごとに呼び出しが約11倍なので、30 から 40 で約120倍。筆者の環境なら、30秒を超える計算です。メモ化版は一瞬のままです。
見抜き方1:データを2倍にして測る
コードを読んでも速さが分からないときは、データを2倍にして、時間が何倍になるかを測るのがいちばん確実です。前のコード(例1)の続きに書きます。
def doubling_check(func, make_data, size):
    """データを2倍にしたとき、時間が何倍になるかを測る(ぶれを減らすため3回測って最短を使う)"""
    times = []
    for n in [size, size * 2]:
        data = make_data(n)
        best = None
        for _ in range(3):
            t0 = time.perf_counter()
            func(data)
            t = time.perf_counter() - t0
            best = t if best is None else min(best, t)
        times.append(best)
    print(f"{func.__name__}: {size}件 {times[0]:.4f}秒 → {size * 2}件 {times[1]:.4f}秒({times[1] / times[0]:.1f}倍)")


def make_nums(n):
    return [random.randint(1, n * 10) for _ in range(n)]


doubling_check(find_dups_list, make_nums, 10000)
doubling_check(find_dups_set, make_nums, 1000000)
実行結果:
find_dups_list: 10000件 0.3309秒 → 20000件 1.0930秒(3.3倍)
find_dups_set: 1000000件 0.1890秒 → 2000000件 0.3753秒(2.0倍)
この実行では、リスト版が 3.3 倍、set版が 2.0 倍でした。目安はこうです👇
- 約2倍:件数に比例する。データが増えても素直に伸びる
- 約4倍:二重ループ型。10倍のデータで100倍、100倍のデータで1万倍かかる
- 数倍〜何十倍に跳ねる:例2のような、組み合わせが爆発する型
1回だけ測ると、ほかの処理の影響で数字がぶれます。このコードのように何回か測って最短を使うと、傾向が見やすくなります。それでも多少はぶれるので、「2倍寄りか、4倍寄りか」を見るくらいの気持ちで十分です。
見抜き方2:コードの「形」で気づく
測る前に、コードを読むだけで「怪しい」と気づける形もあります。AIのコードを受け取ったら、次の形がないか探してみてください。
- ループの中で、リストに
in・.index()・.count()・.remove():どれも先頭から見ていくので、二重ループになる。検索が目的なら set や dict に変えられないか考える - ループの中で
pop(0)やinsert(0, x):先頭を出し入れするたびに、残りを全部ずらしている。collections.dequeを検討する - 同じ引数で何度も呼ばれる再帰:例2の形。
@cacheでメモ化できないか考える - ループの中で毎回
sorted()やリスト全体のコピー:ループの外で1回だけやれば済むことが多い
どれも「小さいデータでは問題なく動く」のが厄介なところです。テストの10件では一瞬なのに、本番の10万件で止まる。だからこそ、受け取ったコードの形と、件数を増やしたときの伸び方を、自分で確かめる習慣が効いてきます。
AIに頼むときのひと工夫
AIへの頼み方でも、遅いコードはかなり防げます。
- 「10万件でも速く動くように」と、データの量を伝える
- 返ってきたコードに「データが2倍になると、時間は何倍になりますか?」と聞いてみる
- 説明をうのみにせず、上の
doubling_checkで実際に測って確かめる
AIは便利ですが、その答えが目的に合っているかを判断するのは、使う人の役目です。手順の違いで速さが変わることを知っていれば、「動いたけど、これで大丈夫?」と立ち止まれるようになります。
よくあるつまずき ⚠️
- 小さいデータでしか測らない:100件ではどちらも一瞬で、差が見えません。少なくとも数千〜数万件で比べましょう
- 速くした版の答えを確かめない:書き換えたら、元の版と答えが同じかを必ず比べます。この記事のコードでも、毎回「答えが同じ」を表示しています
- メモ化を測るときに前の結果が残っている:
@cacheは答えを覚え続けるので、続けて測ると速く見えすぎます。例2ではcache_clear()で消してから測っています
まとめ
- AIのコードは答えが合っていても、手順しだいで速さが何百倍も変わる
- ループの中でリストに
inを使うと二重ループになる。set に変えるだけで劇的に速くなる - 同じ引数の計算をくり返す再帰は、
@cacheのメモ化で一度ずつにできる - データを2倍にして、時間が約2倍か約4倍かを測れば、遅い型を見抜ける
- コードの形(ループの中の
in・pop(0)・同じ引数の再帰)にも目を向ける
手元にあるAIが書いたコードで、ぜひ一度 doubling_check を試してみてください🚀
\ Pythonでゲームを作りたい方へ /
筆者は、入門を終えた人向けに、画面の中でキャラクターが動き、キーボードで操作するゲームを7本作る講座を公開しています。最短の手数を自動で探すパズルや、歩数の地図を見て追いかけてくるねこを、自分の手で書きながら「答えにたどり着く手順の考え方(アルゴリズム)」を身につけます。完成版の7本は、パソコンのブラウザでそのまま遊べます。
→ 作って学ぶPythonゲームプログラミング(完成した7本を遊んでみる)
基礎の文法に不安がある方は、先に無料の入門コース「作って学ぶPythonプログラミング入門」(全7章52レッスン)からどうぞ。
→ 無料の入門コースを見る
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR