Python実践試験で問われる標準ライブラリ活用まとめ|実行結果を予測できるかで差がつく頻出モジュール
「実践試験の勉強を始めたけど、標準ライブラリが多すぎてどこから手をつければいいかわからない…」
「Counter や defaultdict は知っているけど、実行結果を予測しろと言われると自信がない」
こんな悩み、ありますよね。
Python 3 エンジニア認定実践試験は、40問・75分・合格ライン70%で、合格率は約48.6%。受験者のおよそ半分が不合格になる試験です。主教材の「Python実践レシピ」(技術評論社)は標準ライブラリの使い方を幅広く扱っているため、標準ライブラリの「挙動」を正確に覚えているかが得点を大きく左右します。
この記事では、実践試験の対策として押さえておきたい標準ライブラリを「実行結果を予測できるか」という視点でまとめます。コードはすべて Python 3.13 で実際に動かした結果を載せています。
- 対象読者:基礎試験レベルの文法はわかっていて、実践試験の対策を始めた方
- 難易度:初級〜中級
- この記事でわかること:collections・itertools・functools・re・dataclasses・datetime の「引っかかりやすい挙動」
出題範囲の全体像ではなく、コードを読んで答えを出す力に絞って一緒に見ていきましょう!
なぜ実践試験では「標準ライブラリの挙動」が問われるのか
実践試験の問題は、イメージとしては「このコードを実行すると何が表示されるか」「この目的に合う書き方はどれか」を選ぶ形が中心です。つまり、関数の名前を知っているだけでは足りず、戻り値の形・境界での動き・よくある落とし穴まで理解している必要があります。
講師として受講生の学習を見てきた実感として、実践試験で点が伸びない人の多くは「使ったことはあるけど、戻り値を正確に言えない」状態です。たとえば Counter.most_common() がリストを返すのか辞書を返すのか、ここで迷うと選択肢を絞り込めません。
ここが重要です👇
- 「何ができるか」より「何が返ってくるか」を覚える
- 存在しないキー・空のデータ・上限を超えたときなど境界の動きを確認する
- 公式の過去問集はないので、自分で動かして確かめるのがいちばん確実
collections:Counter・defaultdict・deque の戻り値を押さえる
まずは出番の多い collections モジュールです。次のコード、実行せずに結果を答えられますか?
from collections import Counter, defaultdict, deque

# ① Counter:出現回数を数える
words = ["apple", "banana", "apple", "cherry", "banana", "apple"]
c = Counter(words)
print(c.most_common(2))   # 多い順に上位2件
print(c["grape"])         # 存在しないキーは?

# ② defaultdict:キーがなくても自動で初期値を作る
groups = defaultdict(list)
for name, dept in [("佐藤", "営業"), ("鈴木", "開発"), ("高橋", "営業")]:
    groups[dept].append(name)
print(dict(groups))

# ③ deque:maxlen を超えると古いものから押し出される
recent = deque(maxlen=3)
for i in range(5):
    recent.append(i)
print(recent)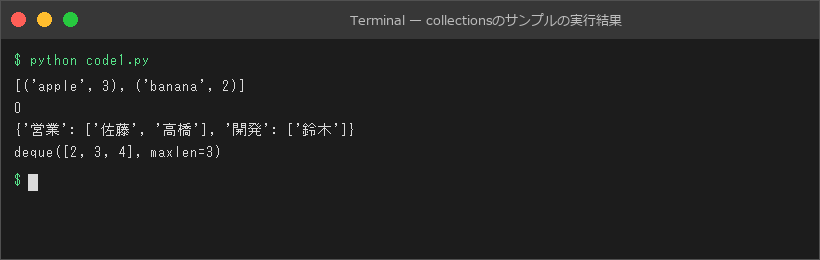
実行結果は次のとおりです。
ポイントをまとめるとこんな感じです👇
most_common(2)は(要素, 回数)のタプルのリストを返す。辞書ではないCounterは存在しないキーを参照してもKeyErrorにならず、0 を返すdefaultdict(list)は、初めて出てきたキーに対して自動で空のリストを作るdeque(maxlen=3)は上限を超えると反対側(古い方)から自動で捨てる。エラーにはならない
特に「Counter で存在しないキーは 0」「通常の dict なら KeyError」の対比は、ひっかけとして作りやすいポイントです。dict との違いをセットで覚えておきましょう。
itertools・functools:groupby の「ソート忘れ」と lru_cache
次は itertools と functools です。ここは「知っているつもり」で間違えやすい代表格です。
from itertools import groupby
from functools import lru_cache

# ① groupby は「隣り合った同じ値」しかまとめない
data = ["A", "A", "B", "A", "B"]
print([(k, len(list(g))) for k, g in groupby(data)])

# 先にソートしてからなら、期待どおりにまとまる
print([(k, len(list(g))) for k, g in groupby(sorted(data))])

# ② lru_cache:同じ引数の結果を覚えておく
@lru_cache(maxsize=None)
def fib(n):
    return n if n < 2 else fib(n - 1) + fib(n - 2)

print(fib(30))
print(fib.cache_info())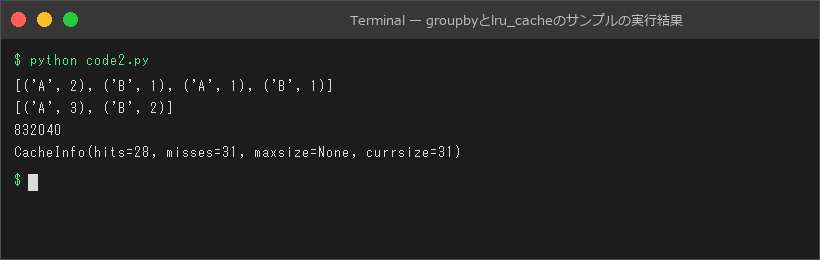
ここが重要です👇
groupbyは連続して並んでいる同じ値だけをまとめる。全体を集計したいなら先にsorted()するgroupbyの戻り値のgはイテレータなので、len(list(g))のようにリストに変換してから数える@lru_cacheは同じ引数での呼び出し結果を覚えておき、2回目以降は計算を省略する。cache_info()でヒット数などを確認できる
受講生を見ていると、groupby を SQL の GROUP BY と同じものだと思い込んでソートしない方の結果を選んでしまうケースがとても多いです。「隣り合ったものだけ」と一言で覚えておくと、迷わなくなりますよ😊
re・dataclasses・datetime:細かい違いが問われる3つ
最後は、似た関数の違いや初期値の扱いなど、細部の理解が問われやすいものをまとめて確認します。
import re
from dataclasses import dataclass, field
from datetime import datetime, timedelta

# ① re.match / search / fullmatch の違い
text = "ID: 12345"
print(re.match(r"\d+", text))       # 先頭から一致するか
print(re.search(r"\d+", text))      # どこかに一致するか
print(re.fullmatch(r"\d+", "12345"))  # 全体が一致するか

# ② dataclass:リストの初期値は default_factory で
@dataclass
class Cart:
    owner: str
    items: list = field(default_factory=list)

a = Cart("A")
b = Cart("B")
a.items.append("りんご")
print(a, b)

# ③ datetime と timedelta
start = datetime(2026, 9, 29, 7, 0)
print(start + timedelta(days=3, hours=20))
print((datetime(2026, 10, 1) - start).total_seconds())
実行結果はこちらです。
None
<re.Match object; span=(4, 9), match='12345'>
<re.Match object; span=(0, 5), match='12345'>
Cart(owner='A', items=['りんご']) Cart(owner='B', items=[])
2026-10-03 03:00:00
147600.0
ポイントをまとめるとこんな感じです👇
re.matchは文字列の先頭からしか探さない。"ID: 12345"は先頭が数字ではないのでNonere.searchは文字列のどこかに一致すればよく、re.fullmatchは全体が一致したときだけ Match オブジェクトを返すdataclassでリストなどのミュータブルな初期値を使うときはfield(default_factory=list)。インスタンスごとに別のリストが作られるので、aに追加してもbは空のままtimedelta(days=3, hours=20)を足すと日付をまたいで正しく計算される。差分のtotal_seconds()はfloatで返る
ちなみに、items: list = [] のように書くと、クラスを定義した時点で次のエラーになります(Python 3.13 で確認)。
ValueError: mutable default <class 'list'> for field items is not allowed: use default_factory「なぜ default_factory が必要なのか」まで説明できれば、このあたりの問題は怖くありません⚠️
効率よく覚えるための学習のコツ
標準ライブラリは範囲が広いので、闇雲に覚えようとすると挫折しがちです。おすすめの進め方はこちらです。
- 「Python実践レシピ」の該当ページのコードを自分で打って動かす(読むだけで済ませない)
- 動かしたら、引数を1つ変えて結果を予想→実行して答え合わせする
- 間違えたものだけをメモにまとめ、試験前はそのメモを重点的に見直す
- 仕上げに本番と同じ形式の問題で、時間を計って解く
4つ目の「本番形式の演習」は、公式の過去問集がない実践試験では用意するのが意外と大変です。筆者が運営する本試験形式の模擬試験6回分がある実践試験の対策コースでは、本番と同じ40問形式で演習できるので、仕上げの段階で使ってみるのもひとつの方法です。
まとめ
- 実践試験では、標準ライブラリの戻り値の形と境界での挙動が得点に直結する
Counterは存在しないキーで 0、deque(maxlen)は古い方から捨てるgroupbyは隣り合う値だけをまとめるので、先にソートre.match/search/fullmatchの違い、dataclassのdefault_factoryは要チェック- 覚え方は「動かす→少し変えて予想→答え合わせ」の繰り返しが最短
標準ライブラリの挙動は、一度自分の手で確かめると忘れにくくなります。「むずかしそう」を「できそう」に変えるために、今日紹介したコードをぜひ試してみてください🚀
よくある質問
Q1. 標準ライブラリは全部暗記しないといけませんか?
すべての関数を暗記する必要はありません。主教材の「Python実践レシピ」で扱われているモジュールを中心に、よく使う関数の戻り値と代表的な落とし穴を押さえるのが現実的です。
Q2. 実践試験で使われる Python のバージョンは?
出題の前提となるバージョンなど、試験制度の詳細は変わる可能性があります。最新の情報は協会公式サイト(pythonic-exam.com)をご確認ください。
Q3. 実践試験の合格ラインと合格率はどれくらいですか?
合格ラインは70%で、合格率は約48.6%です。基礎試験(合格率 約76%)より難しく、コードの挙動を正確に読む力が求められます。
\ 受験前に、今の実力を無料でチェック /
本記事の筆者が運営する試験対策の専門サービスでは、本番と同じ形式の模擬試験(基礎・実践・データ分析 各1回分)を無料で受験できます。クレジットカードの登録は不要です。
▶ 試験の全体像・勉強法のまとめは完全ガイドへ
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR