データ分析試験の数学はどこまで必要?統計・行列・確率の「ここまでで十分」ラインをコードで確認
「データ分析試験を受けたいけど、数学が出るって聞いて手が止まっています…」
「統計とか行列とか、高校数学からやり直さないとダメですか?」
こんな不安、ありますよね。文系出身の方や、数学から長く離れている社会人の方から本当によくいただく相談です。
この記事では、Python 3 エンジニア認定データ分析試験の「数学の基礎」分野について、どこまでやれば十分で、どこから先は深追いしなくていいのかを整理します。実際に NumPy・pandas で動かしたコードと実行結果も載せるので、「数式を眺める」のではなく「手を動かして確認する」形で一緒に見ていきましょう!
対象読者:データ分析試験の受験を考えている初〜中級者(数学に苦手意識がある方向け)
結論:必要なのは「計算力」より「用語と意味がわかること」
先に結論をお伝えすると、データ分析試験の数学は大学レベルの証明や複雑な計算を解く力は求められません。
主教材の「Pythonによるあたらしいデータ分析の教科書」(翔泳社)には数学の基礎を扱う章があり、そこでは大きく次の4つが扱われています。
- 数式を読むための基礎知識(記号の読み方、Σ など)
- 線形代数(ベクトル・行列とその積)
- 基礎解析(関数・微分・積分の考え方)
- 確率と統計(平均・分散・標準偏差・確率)
イメージとしては、「この記号は何を意味するか」「このコードは何を計算しているか」がわかれば合格ラインに届く、という感覚です。出題の中心は NumPy・pandas・Matplotlib・scikit-learn などライブラリの章のほうで、数学は全体から見ると一部です。分野ごとの出題の割合など最新の出題範囲は、協会公式サイト(pythonic-exam.com)をご確認ください。
講師として受講生を見てきた実感でも、数学が原因で落ちる人より、数学を怖がって勉強の順番を間違える人のほうがずっと多いです。最初の数学の章で何週間も止まってしまい、配点の大きいライブラリの章に時間を回せなかった…というパターンですね。
分野別「ここまでで十分」ライン
| 分野 | 押さえるべきこと | 深追いしなくていいこと |
|---|---|---|
| 数式を読む基礎 | Σ(総和)・添字・関数の記号の読み方 | 数式の変形・証明 |
| 線形代数 | 行列の積のルール、形(shape)が合う条件 | 逆行列・固有値の手計算 |
| 基礎解析 | 微分=傾き、積分=面積という意味 | 複雑な関数の微分・積分の計算 |
| 確率と統計 | 平均・中央値・分散・標準偏差の意味と違い | 検定などの高度な統計手法 |
ポイントは、「Pythonで計算したらどうなるか」とセットで覚えることです。ここからは、特に差がつきやすい「統計」と「線形代数」をコードで確認していきます。
統計:分散の「ddof」の違いは要注意⚠️
まずは平均・中央値・分散・標準偏差です。ここで多くの人がつまずくのが、NumPy と pandas で分散の値が違うという点です。これ、実行せずに答えられますか?コードのすぐ下に実際の実行結果を載せています。
import numpy as np
import pandas as pd

# 5人分のテストの点数
scores = np.array([60, 70, 70, 80, 95])

print("平均値:", scores.mean())
print("中央値:", np.median(scores))

# 分散・標準偏差:NumPy は ddof=0(母分散)が既定
print("NumPy の分散  :", scores.var())
print("NumPy の標準偏差:", round(scores.std(), 3))

# pandas は ddof=1(不偏分散)が既定
s = pd.Series(scores)
print("pandas の分散  :", s.var())
print("pandas の標準偏差:", round(s.std(), 3))

# NumPy でも ddof=1 を指定すれば pandas と同じになる
print("NumPy ddof=1 の分散:", scores.var(ddof=1))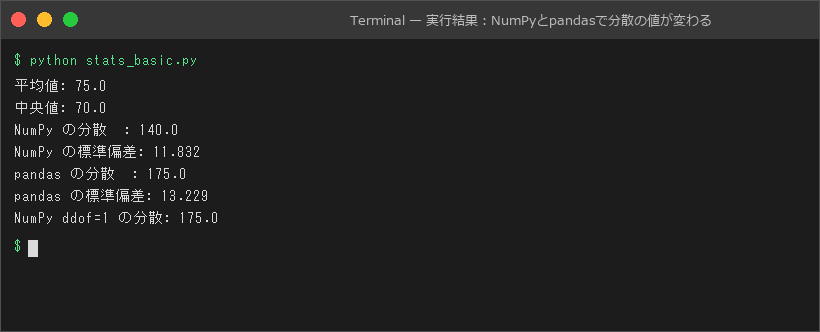
ここが重要です👇
- 平均値は 75.0 なのに、中央値は 70.0。95点という大きめの値に平均が引っぱられるのが平均と中央値の違いです
- 同じデータなのに、NumPy の分散は 140.0、pandas の分散は 175.0
- 理由は
ddof:NumPy のvar()は既定が ddof=0(データの個数 n で割る)、pandas のvar()は既定が ddof=1(n−1 で割る=不偏分散) - NumPy でも
ddof=1を指定すれば 175.0 になり、pandas と一致します
つまり、「分散の公式を暗記しているか」より、「どのライブラリがどちらで割っているか」を知っているかが問われやすいところです。受講生の方からも「計算は合っているはずなのに選択肢と合わない」という質問をよくいただくのですが、原因はたいていこの ddof です。
線形代数:「*」と「@」の違いと shape のルール
線形代数で押さえたいのは、行列の積がどう計算されるかと、どんな形(shape)なら掛け算できるかの2点です。
import numpy as np

A = np.array([[1, 2],
              [3, 4]])
B = np.array([[5, 6],
              [7, 8]])

# * は「要素ごと」の掛け算
print("A * B =")
print(A * B)

# @ は「行列の積」(np.dot(A, B) と同じ)
print("A @ B =")
print(A @ B)

# 行列の積は順番を入れ替えると結果が変わる
print("B @ A =")
print(B @ A)

# 形(shape)が合わないとエラーになる
C = np.array([[1, 2, 3]])   # shape は (1, 3)
print("A.shape:", A.shape, " C.shape:", C.shape)
try:
    print(A @ C)
except ValueError as e:
    print("エラー:", e)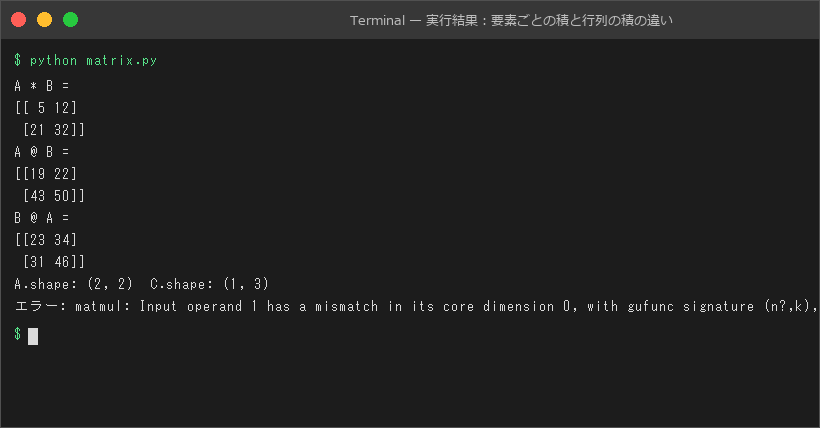
実行結果はコードの直下の画像のとおりです。
ポイントをまとめるとこんな感じです。
A * Bは同じ位置の要素どうしの掛け算(1×5=5、2×6=12…)A @ Bは行列の積。左上の 19 は「Aの1行目 × Bの1列目」= 1×5 + 2×7 ですA @ BとB @ Aは結果が違う。行列の積は順番を入れ替えられません- (2, 2) と (1, 3) のように、左の列数と右の行数が合わないと ValueError になります
「(n, k) と (k, m) を掛けると (n, m) になる」というルールさえ言えれば、線形代数の基本は大丈夫です。手で逆行列を計算できるようになる必要はありません。
確率:試行回数を増やすと理論値に近づく
確率は、「たくさん試すと理論上の確率に近づく」という感覚を持っておくと理解が早いです。NumPy の乱数でサイコロを振ってみましょう。
import numpy as np

rng = np.random.default_rng(0)  # 乱数の種を固定して結果を再現できるようにする

# サイコロを n 回振って「6が出た割合」を調べる
for n in [10, 100, 10000]:
    rolls = rng.integers(1, 7, size=n)  # 1〜6 の整数(7は含まない)
    ratio = (rolls == 6).mean()
    print(f"{n:>6}回: 6が出た割合 = {ratio:.3f}")

print("理論上の確率 1/6 =", round(1 / 6, 3))
実行結果です👇
    10回: 6が出た割合 = 0.100
   100回: 6が出た割合 = 0.160
 10000回: 6が出た割合 = 0.169
理論上の確率 1/6 = 0.167- 10回ではたまたま 0.100 と、理論値 0.167 からかなりずれています
- 10000回では 0.169 となり、ほぼ 1/6 に近づきました
rng.integers(1, 7)は 7を含まないので、1〜6 の整数になります(終わりの値を含まないのはrange()と同じ考え方です)
微分・積分(基礎解析)も同じで、「微分はグラフの傾き」「積分は面積」という意味が言えればまずは十分です。計算練習に時間をかけるより、用語の意味を一言で説明できるかを確認しましょう。
数学が苦手な人のおすすめ学習順
- 数学の章は1周だけ流し読みする(わからない所に印をつけて先へ進む)
- NumPy・pandas の章を学びながら、印をつけた所をコードで確かめる(今回のように ddof や @ を実際に動かす)
- Matplotlib・scikit-learn まで終えたら、数学の章をもう一度読む(2周目は驚くほど読みやすくなります)
- 模擬試験で間違えた数学の問題だけ、教科書の該当ページに戻って復習する
講師としての実感ですが、数学は「先に完璧にする」より「ライブラリと一緒に何度も触れる」ほうが定着します。最初は意味がピンとこなかった標準偏差も、pandas の describe() で毎回目にしているうちに自然と身につく方が多いです。
本番形式の問題で「数学の問題がどんな聞かれ方をするのか」を確かめたい方は、筆者が運営する本試験形式の模擬試験4回分があるデータ分析試験の対策コースも参考にしてみてください。協会非公認の独自教材ですが、出題範囲に沿って解説つきで演習できます。
まとめ
- データ分析試験の数学は「用語と意味がわかる」レベルが目標。証明や複雑な計算は不要
- 統計は平均と中央値の違い、NumPy(ddof=0)と pandas(ddof=1)の分散の違いを押さえる
- 線形代数は「*」と「@」の違いとshape が合う条件を押さえる
- 確率・微分積分は意味を一言で説明できればまずは十分
- 数学の章で止まらず、ライブラリの学習と行き来しながら理解を深める
「数学がむずかしそう」を「コードで確かめればできそう」に変えて、ぜひ試してみてください😊
よくある質問
Q1. 高校数学を一通り復習してから勉強を始めるべきですか?
その必要はありません。主教材の数学の章を読み、わからない用語だけピンポイントで調べる進め方で十分です。全範囲の復習から始めると、ライブラリの章に使う時間が足りなくなりがちです。
Q2. 試験で手計算が必要な問題は出ますか?
具体的な出題内容は公表されていないため断言はできませんが、主教材の内容が理解できていれば対応できる範囲です。行列の積や平均・分散など、教科書に出てくる基本的な計算は自分で一度手を動かして確認しておくと安心です。最新の出題範囲は協会公式サイトをご確認ください。
Q3. 統計検定など別の資格の勉強もしたほうがいいですか?
データ分析試験の合格だけが目的なら、主教材の範囲に集中するのが効率的です。統計をより深く学びたくなったら、合格後のステップとして検討するとよいでしょう。
\ 本番形式の模擬試験を無料で試せます /
筆者が運営するPython3エンジニア試験ラボでは、基礎・実践・データ分析の3試験について、本試験と同じ形式の模擬試験を各1回分、無料で受験できます(クレジットカード登録不要)。本番の操作感と自分の実力チェックにどうぞ。
▶ 試験の全体像・勉強法のまとめは完全ガイドへ
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR