機械学習の評価指標入門!正解率が高いのに使えないモデルを混同行列・適合率・再現率で見抜く方法
「scikit-learnでモデルを作ったら正解率が95%も出た!…のに、実際に使ってみたら全然役に立たない」
機械学習を学び始めると、こんな経験をすることがありますよね。実はこれ、「正解率(accuracy)」だけでモデルを評価していることが原因になっていることが多いんです。
この記事では、工場の検査データ(不良品が約5%だけ混ざっている)を題材に、混同行列・適合率・再現率・F1スコアという評価指標を、実際にコードを動かしながら見ていきます。
- 難易度:初〜中級(scikit-learnで
fitとpredictを書いたことがある方向け) - 必要なもの:Python 3 と scikit-learn(
pip install scikit-learn) - この記事でわかること:正解率のワナ、混同行列の読み方、見逃しを減らす2つの方法
「評価指標ってむずかしそう」を「表を見れば判断できそう」に変えていきましょう!🚀
正解率94.8%なのに不良品を1つも見つけられないモデル
まずは、ちょっと意地悪な実験から始めます。データは make_classification で人工的に作り、不良品(1)が約5%、良品(0)が約95% という偏った割合にしています。
そのうえで、何も考えずに「全部良品です」と答えるだけのモデル(DummyClassifier)の成績を測ってみます。
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score, recall_score

# 不良品が約5%しかない「検査データ」を人工的に作る(0=良品, 1=不良品)
X, y = make_classification(
    n_samples=2000, n_features=6, n_informative=4,
    weights=[0.95, 0.05], class_sep=2.0, random_state=1
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=0
)
print("テストデータの件数:", len(y_test), "/ うち不良品:", y_test.sum())

# 何も考えず「全部良品」と答えるだけのモデル
dummy = DummyClassifier(strategy="most_frequent")
dummy.fit(X_train, y_train)
pred = dummy.predict(X_test)

print("正解率:", round(accuracy_score(y_test, pred), 3))
print("不良品を見つけられた割合(再現率):", recall_score(y_test, pred))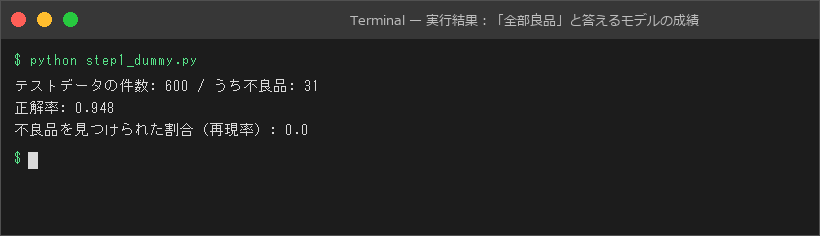
ポイントをまとめるとこんな感じです。
weights=[0.95, 0.05]で「良品95%・不良品5%」の偏ったデータを作るstratify=yで、訓練用とテスト用の不良品の割合をそろえるstrategy="most_frequent"は「いちばん多いクラスを常に答える」ズルいモデル
実行すると、正解率は 0.948(94.8%)。一見すごく優秀に見えますよね。
でも、テストデータに31個ある不良品を1つも見つけられていません(再現率 0.0)。検査装置としてはまったく使い物になりません⚠️
つまり、データが偏っていると、正解率は「多いほうを当てただけ」で高くなってしまうんです。これが「正解率のワナ」です。
混同行列で「何をどう間違えたか」を見る
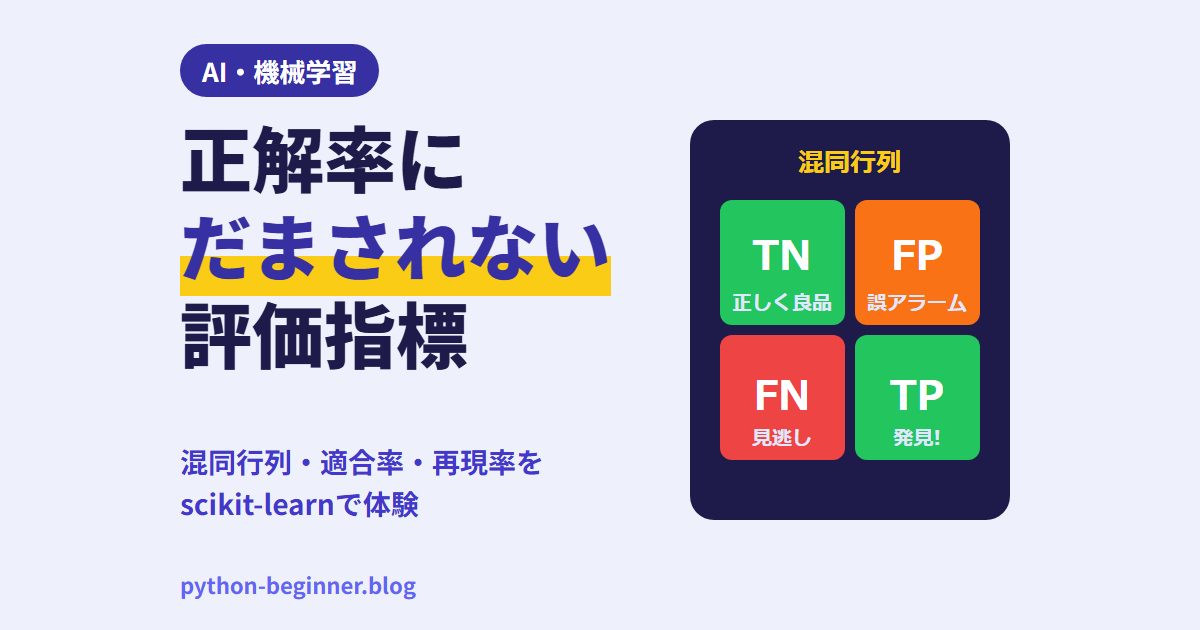
そこで登場するのが混同行列(confusion matrix)です。イメージとしては、「本当の答え」と「モデルの予測」の組み合わせを数えた2×2の表です。
| 予測:良品 | 予測:不良品 | |
|---|---|---|
| 本当は良品 | TN(正しく良品と判定) | FP(誤アラーム) |
| 本当は不良品 | FN(見逃し) | TP(正しく不良品と判定) |
そして、この表から計算するのが次の3つの指標です。
- 適合率(precision)= TP ÷ (TP + FP):「不良品だ!」と言ったもののうち、本当に不良品だった割合(誤アラームの少なさ)
- 再現率(recall)= TP ÷ (TP + FN):本当の不良品のうち、見つけられた割合(見逃しの少なさ)
- F1スコア:適合率と再現率の調和平均。両方のバランスを1つの数字で見たいときに使う
では、ちゃんと学習するモデル(ロジスティック回帰)で混同行列を出してみましょう。ここが重要です👇
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, classification_report

X, y = make_classification(
    n_samples=2000, n_features=6, n_informative=4,
    weights=[0.95, 0.05], class_sep=2.0, random_state=1
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=0
)

# ちゃんと学習するモデル(ロジスティック回帰)
model = LogisticRegression()
model.fit(X_train, y_train)
pred = model.predict(X_test)

# 混同行列:行が「本当の答え」、列が「モデルの予測」
print(confusion_matrix(y_test, pred))
print(classification_report(y_test, pred, target_names=["良品", "不良品"], digits=3))実行結果は次のとおりです(classification_report の不良品の行を抜き出しています)。
| 混同行列 | 予測:良品 | 予測:不良品 |
|---|---|---|
| 本当は良品 | 568 | 1 |
| 本当は不良品 | 10 | 21 |
| 指標 | 値 | 意味 |
|---|---|---|
| 正解率 | 0.982 | 全600件のうち正しく判定できた割合 |
| 不良品の適合率 | 0.955 | 「不良品」と判定した22件のうち21件が本当に不良品 |
| 不良品の再現率 | 0.677 | 不良品31件のうち見つけられたのは21件 |
| 不良品のF1スコア | 0.792 | 適合率と再現率のバランス |
正解率は98.2%と高いのですが、混同行列を見ると不良品31件のうち10件を見逃していることがわかります。正解率だけ見ていたら、まず気づけないポイントですよね。
ちなみに、最初は class_sep を指定せずに(デフォルトの1.0で)データを作ったところ、ロジスティック回帰でも不良品を1件も予測しない結果になりました。良品と不良品の区別がつきにくいデータだと、学習したモデルでも「全部良品」に逃げてしまうことがあるんです。この記事では違いを見やすくするために class_sep=2.0(クラスの離れ具合を大きくする)を指定しています。
見逃しを減らす2つの方法:class_weightとしきい値
検査の現場では、「誤アラームが多少増えても、不良品の見逃しは減らしたい」ということがよくあります。そんなときに使える方法が2つあります。
class_weight="balanced":数の少ないクラス(不良品)の間違いを重く扱って学習させる- しきい値の調整:
predict_probaで「不良品である確率」を出し、何%以上なら不良品と判定するかを自分で決める(predictは0.5が境目)
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix, classification_report

X, y = make_classification(
    n_samples=2000, n_features=6, n_informative=4,
    weights=[0.95, 0.05], class_sep=2.0, random_state=1
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=0
)

# 少ない「不良品」の見逃しを重く扱うように学習させる
model = LogisticRegression(class_weight="balanced")
model.fit(X_train, y_train)
pred = model.predict(X_test)

print(confusion_matrix(y_test, pred))
print(classification_report(y_test, pred, target_names=["良品", "不良品"], digits=3))

# しきい値(不良品と判定する確率のライン)を変えると?
proba = model.predict_proba(X_test)[:, 1]
for th in [0.3, 0.5, 0.7]:
    p = (proba >= th).astype(int)
    tn, fp, fn, tp = confusion_matrix(y_test, p).ravel()
    print(f"しきい値{th}: 見つけた不良品={tp}, 見逃し={fn}, 誤アラーム={fp}")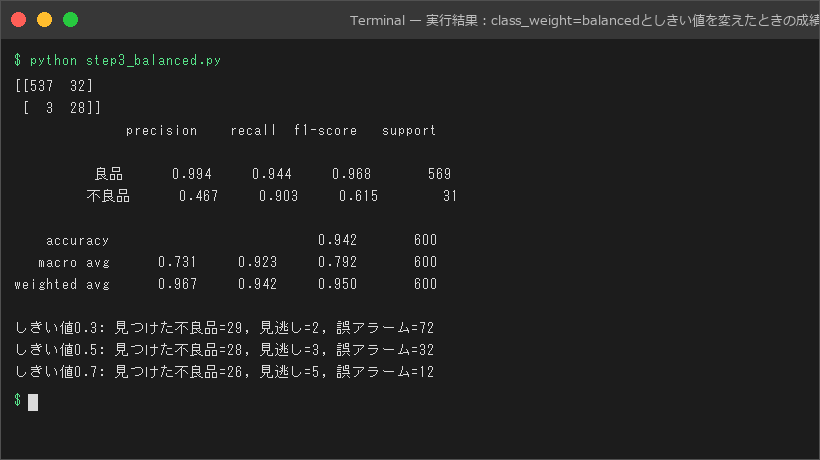
ポイントをまとめるとこんな感じです。
class_weight="balanced"にすると、見逃しは 10件 → 3件 に減り、再現率は 0.677 → 0.903 に上がった- その代わり誤アラームは 1件 → 32件 に増え、適合率は 0.955 → 0.467 に下がった
- 正解率も0.982 → 0.942に下がっているが、「見逃しを減らす」目的なら、こちらのモデルのほうが役に立つ場面もある
- しきい値を0.3に下げると見逃し2件・誤アラーム72件、0.7に上げると見逃し5件・誤アラーム12件。しきい値で「見逃し」と「誤アラーム」のどちらを優先するか調整できる
これ、どのしきい値が正解だと思いますか? 実は正解は目的によって変わります。たとえば次のように考えます。
- 不良品の流出が大きな損害になる → 再現率を重視(しきい値を下げる)
- 誤アラームのたびに人が再検査する手間が大きい → 適合率を重視(しきい値を上げる)
- どちらも同じくらい大事 → F1スコアで比べる
まとめ
今回は、機械学習の評価指標を「正解率のワナ」から順番に見てきました。
- データが偏っていると、「全部良品」と答えるだけで正解率94.8%が出てしまう
- 混同行列を見れば、「見逃し(FN)」と「誤アラーム(FP)」がそれぞれ何件あるかがわかる
- 適合率は誤アラームの少なさ、再現率は見逃しの少なさ、F1スコアはその両方のバランス
class_weight="balanced"やしきい値の調整で、見逃しと誤アラームのバランスを目的に合わせて変えられる
モデルを評価するときは、まず confusion_matrix と classification_report を出すクセをつけておくと安心です。ざっくりとした流れがつかめたら、weights や class_sep の値を変えて、指標がどう動くかぜひ試してみてください😊
参考:scikit-learn公式ドキュメント「Metrics and scoring」
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR