Pythonの正規表現入門!reモジュールで日付・電話番号を抜き出してログ集計・入力チェックまで
「ログファイルからエラーの行だけ抜き出したい…」「メモに散らばった日付をまとめて同じ形式にそろえたい…」
こんなとき、split() や in だけで頑張ろうとすると、if文がどんどん増えてしまいますよね。そこで役に立つのが正規表現(せいきひょうげん)です。
この記事では、Python標準の reモジュール を使って、電話番号・日付・メールアドレス・ログの行を「パターンで」抜き出す方法を、実際に動かした結果つきで解説します。
- 対象:if文・for文・関数がひととおり書ける初心者〜中級者
- 難易度:★★☆(記号が多いだけで、考え方はシンプルです)
- 動作確認:Python 3.13(追加インストール不要)
読み終わるころには、「正規表現=呪文」が「正規表現=便利な検索条件」に変わっているはずです。一緒に見ていきましょう!🚀
正規表現とは?イメージは「あいまい検索の条件書き」
正規表現は、「こういう形の文字列」をひとことで表す書き方です。イメージとしては、Excelの検索に「数字が4つ続いて、スラッシュがあって…」という形の条件を渡せる感じです。
まずはよく使う記号だけ押さえましょう。全部覚える必要はなく、この表を手元に置いておけば十分です😊
| 記号 | 意味 | 例 |
|---|---|---|
\d |
数字1文字 | \d\d → 「42」 |
\w |
英数字・アンダースコア(日本語の文字も含む) | \w+ → 「db01」 |
\s |
空白(スペース・タブ・改行) | a\sb → 「a b」 |
. |
改行以外の任意の1文字 | a.c → 「abc」「a-c」 |
+ / * / ? |
1回以上 / 0回以上 / 0か1回 | -? → ハイフンがあってもなくてもOK |
{m,n} |
m回以上n回以下 | \d{2,4} → 数字2〜4桁 |
^ / $ |
行の先頭 / 行の末尾 | ^ERROR → ERRORで始まる行 |
( ) |
グループ(あとで取り出せる) | (\d{4})/ → 年だけ取り出す |
STEP1:search・match・fullmatch の違いを知る
最初のつまずきポイントがここです。reモジュールには「探す」関数が3つあって、どこを見るかが違います。文章の中から電話番号を探してみましょう。
import re

text = "お問い合わせは 03-1234-5678 まで(受付 9:00〜18:00)"

# 電話番号のパターン:数字2〜4桁-数字2〜4桁-数字4桁
pattern = r"\d{2,4}-\d{2,4}-\d{4}"

m = re.search(pattern, text)  # 文字列のどこかにあれば見つける
if m:
    print("見つかった:", m.group())
    print("位置:", m.start(), "〜", m.end())

# match は「先頭から」しか見ない
print("match:", re.match(pattern, text))
# fullmatch は「文字列全体」がパターンに一致するか
print("fullmatch:", re.fullmatch(pattern, "03-1234-5678"))実行すると、search は 03-1234-5678 を見つけて位置「8 〜 20」を返しました。一方で match の結果は None です。
ここが重要です👇
re.search():文字列のどこかにあればOK(いちばんよく使う)re.match():先頭から一致しないとダメ。文章は「お問い合わせは…」で始まるのでNonere.fullmatch():文字列全体がパターン通りか。入力チェックに使う- 見つかるとマッチオブジェクトが返り、
.group()で中身、.start()・.end()で位置が取れる
パターンの前の r"..." はraw文字列です。理由はSTEP4で「実際に失敗する例」と一緒に説明しますね。
STEP2:findall・finditer でまとめて抜き出す
1つ見つけるだけでなく、全部抜き出したいときは findall と finditer を使います。メモの中から「年/月/日」の日付を集めてみましょう。
import re

memo = """10/3 打ち合わせ(2026/10/03)
請求書の締めは2026/10/31、入金予定は2026/11/30です。
来年の予定:2027/1/15 キックオフ"""

# ( ) で囲んだ部分が「グループ」になる
pattern = r"(\d{4})/(\d{1,2})/(\d{1,2})"

# findall:グループがあると、タプルのリストが返る
print(re.findall(pattern, memo))

# finditer:マッチオブジェクトを1つずつ取り出せる
for m in re.finditer(pattern, memo):
    year, month, day = m.groups()
    print(f"{m.group()} → {year}年{int(month)}月{int(day)}日")
findall の結果は [('2026', '10', '03'), ('2026', '10', '31'), ('2026', '11', '30'), ('2027', '1', '15')] でした。
これ、実行せずに気づけましたか? 1行目の先頭にある「10/3」は抜き出されていません。パターンが「数字4桁/」から始まるので、年のない日付は対象外なんです。正規表現は書いた条件どおりにしか動かないので、「何を拾って何を拾わないか」を意識するのがコツです。
ポイントをまとめるとこんな感じです。
- パターンに
( )があると、findallはグループの中身のタプルを返す(日付全体ではない) - 日付全体もグループも欲しいなら
finditerを使い、m.group()とm.groups()を使い分ける - 取り出した値は文字列なので、計算や「03→3」の変換には
int()が必要
STEP3:re.sub で日付の形式を一括変換する
抜き出せたら、次は置き換えです。「2026/10/7」と「2026/10/14」のように桁数がバラバラな日付を、「2026-10-07」の形にそろえます。
import re

lines = [
    "納品日:2026/10/7",
    "検収日:2026/10/14",
    "支払日:2026/11/30",
]

# (?P<名前>...) で名前付きグループ
pattern = re.compile(r"(?P<y>\d{4})/(?P<m>\d{1,2})/(?P<d>\d{1,2})")

def to_iso(m):
    # 月・日を2桁にそろえて「2026-10-07」の形にする
    return f"{m['y']}-{int(m['m']):02d}-{int(m['d']):02d}"

for line in lines:
    print(pattern.sub(to_iso, line))

# 置き換えるだけなら文字列でもOK(\g<名前> でグループを参照)
print(pattern.sub(r"\g<y>年\g<m>月\g<d>日", "締切 2026/10/31"))
実行結果は 納品日:2026-10-07・検収日:2026-10-14・支払日:2026-11-30、最後の行は 締切 2026年10月31日 になりました。
ここが重要です👇
(?P<y>...)の名前付きグループにすると、m['y']のように名前で取り出せて読みやすいre.subの置き換え先に関数を渡すと、マッチごとに関数が呼ばれ、戻り値で置き換わる(ゼロ埋めのような加工ができる)- 単純な並べ替えなら置き換え先は文字列でOK。
\g<名前>でグループを参照できる - 同じパターンを何度も使うときは
re.compile()しておくと、pattern.sub()のように書けてスッキリ
STEP4:初心者がハマる2大トラブル(貪欲マッチとraw文字列)
正規表現で「なんか思った結果にならない…」というとき、原因の多くはこの2つです。実際に失敗させてみましょう。
import re

html = '<p>こんにちは</p><p>正規表現</p>'

# 貪欲(.*):できるだけ長くマッチしようとする
print("貪欲  :", re.findall(r"<p>(.*)</p>", html))

# 非貪欲(.*?):できるだけ短くマッチする
print("非貪欲:", re.findall(r"<p>(.*?)</p>", html))

# raw文字列を付け忘れると…
print(len("\b"), len(r"\b"))
print(re.findall("\bcat\b", "cat catalog cat"))   # 何も見つからない
print(re.findall(r"\bcat\b", "cat catalog cat"))  # 単語の「cat」だけ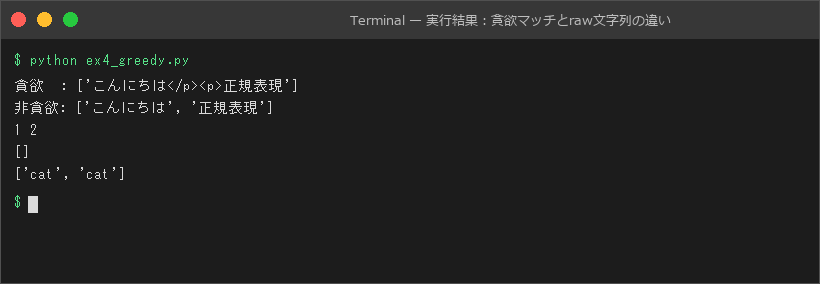
結果を見ると違いが一目でわかります。
- 貪欲マッチ:
.*は「できるだけ長く」マッチするので、最初の<p>から最後の</p>までを1つとして取ってしまう ?を付けた.*?(非貪欲)なら「できるだけ短く」なり、「こんにちは」「正規表現」を別々に取れる"\b"は長さ1、r"\b"は長さ2。普通の文字列だと\bがPythonの「バックスペース文字」に変換されてしまう- そのため
"\bcat\b"では何も見つからず(空リスト)、r"\bcat\b"なら単語としての「cat」だけ(catalogは除外)が取れる
⚠️ 正規表現のパターンには必ず r を付ける、と決めてしまうのがいちばん安全です。なお、HTMLの解析を本格的にやるなら正規表現ではなくBeautifulSoupなどのパーサーを使うのがおすすめです。ここではあくまで貪欲・非貪欲の違いを見るための例です。
STEP5:実践① ログファイルからエラーを集計する
ここからは実務っぽい使い方です。サーバーのログから ERRORの行だけを抜き出し、レベル別の件数と「エラーが多いホスト」を集計してみます。
import re
from collections import Counter

log = """2026-10-07 09:00:01 INFO  起動しました
2026-10-07 09:00:05 WARNING ディスク残量 18%
2026-10-07 09:01:12 ERROR 接続失敗 host=db01 code=504
2026-10-07 09:02:40 INFO  ユーザー user_id=1024 がログイン
2026-10-07 09:03:02 ERROR 接続失敗 host=db02 code=503
2026-10-07 09:05:33 ERROR タイムアウト host=db01 code=504"""

# re.VERBOSE を使うと、パターンに改行やコメントを書ける
line_re = re.compile(r"""
    ^(?P<date>\d{4}-\d{2}-\d{2})\s     # 日付
    (?P<time>\d{2}:\d{2}:\d{2})\s      # 時刻
    (?P<level>INFO|WARNING|ERROR)\s+   # ログレベル
    (?P<msg>.*)$                       # 残りはメッセージ
""", re.VERBOSE | re.MULTILINE)

levels = Counter()
error_hosts = Counter()

for m in line_re.finditer(log):
    levels[m["level"]] += 1
    if m["level"] == "ERROR":
        host = re.search(r"host=(\w+)", m["msg"])
        if host:
            error_hosts[host.group(1)] += 1
        print(f"[{m['time']}] {m['msg']}")

print("レベル別:", dict(levels))
print("エラーの多いホスト:", error_hosts.most_common())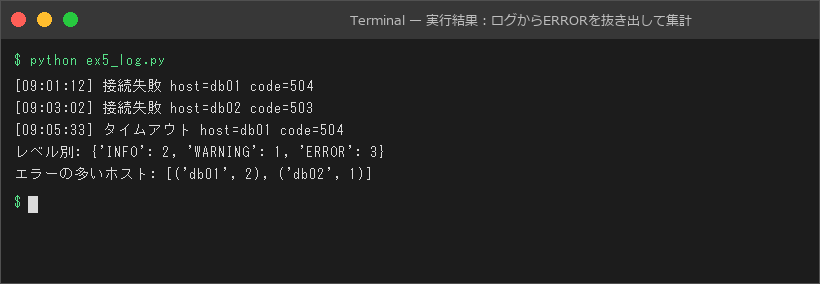
ERRORの3行が時刻つきで表示され、レベル別は INFO: 2, WARNING: 1, ERROR: 3、エラーの多いホストは db01 が2件という結果になりました。
ポイントをまとめるとこんな感じです。
re.VERBOSE:パターンの中に改行・空白・#コメントを書けるので、長いパターンでも読みやすい(パターン内の空白は無視されるので、空白にマッチさせたいときは\sを使う)re.MULTILINE:^と$が「文字列全体」ではなく各行の先頭・末尾にマッチするようになる- フラグは
|でつなげて複数指定できる - 「1行を分解 → メッセージの中をもう一度
re.search」と2段階にすると、パターンが複雑になりすぎない - 集計は
collections.Counterと組み合わせると数行で書ける
実際のログファイルを読むなら、Path("app.log").read_text(encoding="utf-8") で読み込んだ文字列を log の代わりに渡すだけです。
STEP6:実践② 郵便番号・メールアドレスの入力チェック
最後は、フォームの入力チェックです。「全体がその形になっているか」を見たいので、STEP1で出てきた fullmatch の出番です。
import re

POSTAL = re.compile(r"\d{3}-?\d{4}")              # 郵便番号(ハイフンあり・なし)
EMAIL = re.compile(r"[\w.+-]+@[\w-]+(\.[\w-]+)+")  # メールのざっくりチェック

def check(label, pattern, value):
    ok = pattern.fullmatch(value) is not None
    print(f"{label}: {value} → {'OK' if ok else 'NG'}")

for v in ["100-0001", "1000001", "100-00011", "100-0001"]:
    check("郵便番号", POSTAL, v)

for v in ["taro@example.com", "hanako.y+blog@mail.example.jp", "taro@example", "taro example.com"]:
    check("メール", EMAIL, v)

# 全角数字もマッチさせたくないなら ASCII フラグ
POSTAL_ASCII = re.compile(r"\d{3}-?\d{4}", re.ASCII)
print("ASCIIフラグ:", POSTAL_ASCII.fullmatch("100-0001"))
実行してみると、意外な結果が1つ混ざっていました。
100-0001・1000001はOK、桁が多い100-00011はNG(searchだと一部が一致してOKになってしまうところ)- メールは
taro@example.com・hanako.y+blog@mail.example.jpがOK、ドメインに「.」がないtaro@exampleと@がないtaro example.comはNG - ⚠️ 全角の「100-0001」もOKになった。Python 3の
\dは、標準で全角数字などのUnicodeの数字にもマッチするため re.ASCIIフラグを付けると\dが半角の0〜9だけになり、全角はNG(None)になった
この「全角数字も通ってしまう」問題は、知らないとデータベースに全角の郵便番号が入ってしまう原因になります。半角だけ許したい場面では re.ASCII を付けるか、[0-9] と書くのが確実です。
また、メールアドレスの正規表現はあくまで「明らかな入力ミスをはじく」ためのざっくりチェックです。本当に届くアドレスかどうかは、確認メールを送って確かめるのが実務の定番です。
よく使う関数・フラグ早見表
| やりたいこと | 使うもの |
|---|---|
| どこかに含まれるか調べる | re.search() |
| 入力全体が形式どおりかチェック | re.fullmatch() |
| 全部抜き出す(リストでほしい) | re.findall() |
| 全部抜き出す(位置やグループも使う) | re.finditer() |
| 置き換える | re.sub() |
| 同じパターンを何度も使う | re.compile() |
| 長いパターンにコメントを書く | re.VERBOSE |
^・$ を行ごとに効かせる |
re.MULTILINE |
\d・\w を半角だけにする |
re.ASCII |
| 大文字・小文字を区別しない | re.IGNORECASE |
より詳しい仕様は、Python公式ドキュメントのre — 正規表現操作にまとまっています。
まとめ
今回は、Pythonの正規表現(reモジュール)を、実際に動かしながら見てきました。
- 正規表現は「こういう形の文字列」をひとことで表す検索条件
search(どこか)・match(先頭)・fullmatch(全体)の違いを押さえるfindall/finditerで抜き出し、re.subに関数を渡せば加工しながら置き換えられる- パターンには必ず r を付け、
.*の貪欲マッチに注意する \dは全角数字にもマッチする。半角だけならre.ASCIIか[0-9]
正規表現は、最初は記号の多さにひるみますが、「数字が何桁」「ここをグループで取り出す」と一つずつ読めば、ちゃんと意味のある条件になっています。手元のメモやログで、ぜひ試してみてください😊
\ 読んだら、次は自分で作ってみよう /
筆者が運営する無料の入門コース「作って学ぶPythonプログラミング入門」では、こうした基本文法を、割り勘計算機・おみくじ・数当てゲームなどを作りながら身につけます。各章末の定着ドリル(全42問)で、自分の手で書く練習まで。最初の4レッスンは登録なしで読めます。
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR