PythonでPDFを結合・分割!pypdfで請求書をしおり付きでまとめてパスワードもかける方法
「月末に請求書PDFを1つにまとめて送ってほしい、と言われるたびに手作業で結合している…」
「契約書の一部のページだけ抜き出したいけど、無料のWebツールにアップロードするのはちょっと不安…」
フリーランスや個人で仕事をしていると、PDFの結合・分割・ページ抽出・パスワード設定って意外とよく出てきますよね。
この記事では、Pythonのライブラリ pypdf を使って、これらの作業を自分のPCの中だけで自動化する方法を解説します。請求書や契約書のような外に出したくない書類を、Webサービスにアップロードせずに処理できるのが大きなメリットです😊
- 難易度:初級〜中級(for文・関数・pathlib が少し分かればOK)
- 対象読者:書類まわりの手作業を減らしたいフリーランス・個人事業主・事務作業の多い方
- この記事で作るもの:月別の請求書を「しおり付き」で1つにまとめる/契約書から必要なページだけ抜き出す/1ページずつ分割する/パスワードをかける
練習用のサンプルPDFもPythonで作るので、手元に書類がなくてもそのまま試せます。一緒に見ていきましょう!
pypdfとは?準備とインストール
pypdf は、PDFの読み込み・ページの組み替え・暗号化などができる、Pythonだけで書かれたライブラリです。イメージとしては「PDFのページをトランプのカードのように並べ替えたり、抜き出したりできる道具」です。
⚠️ ネットで検索すると PyPDF2 や PdfMerger を使った古い記事がたくさん出てきます。PyPDF2 の開発は現在 pypdf に引き継がれていて、PdfMerger も pypdf 5 で削除されました。実際、今の pypdf で from pypdf import PdfMerger と書くと ImportError になります。この記事では、現行の PdfWriter だけで結合する書き方を使います。
pip install pypdf cryptography reportlab- pypdf:PDFの結合・分割・暗号化の本体
- cryptography:AES-256 でパスワードをかけるときに必要
- reportlab:練習用のサンプルPDFを作るためだけに使います(自分の書類で試すなら不要)
この記事のコードは pypdf 6.14.2 で動作を確認しています。
練習用のサンプルPDFを作る
まずは練習台として、月別の請求書3つと、4ページの契約書を作ります。中身は見出しとページ番号だけのシンプルなものです。
from pathlib import Path
from reportlab.lib.pagesizes import A4
from reportlab.pdfbase import pdfmetrics
from reportlab.pdfbase.cidfonts import UnicodeCIDFont
from reportlab.pdfgen import canvas

# 日本語を表示できるフォントを登録(ReportLab に最初から入っている)
pdfmetrics.registerFont(UnicodeCIDFont("HeiseiKakuGo-W5"))

def make_pdf(path, titles):
    """titles の数だけページがあるPDFを作る"""
    c = canvas.Canvas(str(path), pagesize=A4)
    for i, title in enumerate(titles, start=1):
        c.setFont("HeiseiKakuGo-W5", 28)
        c.drawString(60, 760, title)
        c.setFont("HeiseiKakuGo-W5", 14)
        c.drawString(60, 720, f"{path.name}  {i} / {len(titles)} ページ")
        c.showPage()  # ページを確定して次のページへ
    c.save()

folder = Path("docs")
folder.mkdir(exist_ok=True)

for month in ["2026-08", "2026-09", "2026-10"]:
    make_pdf(folder / f"請求書_{month}.pdf", [f"請求書 {month}"])

make_pdf(folder / "業務委託契約書.pdf",
         ["業務委託契約書(表紙)", "第1条〜第5条", "第6条〜第10条", "署名欄"])

for p in sorted(folder.glob("*.pdf")):
    print("作成:", p.name)
ポイントをまとめるとこんな感じです👇
UnicodeCIDFont("HeiseiKakuGo-W5")で、ReportLab に最初から入っている日本語フォントを使えるようにしています(フォントファイルの用意は不要)c.showPage()を呼ぶたびに1ページ確定します。titlesの数がそのままページ数になります- ファイル名を
請求書_2026-08.pdfのように「年-月」の形にしておくのがコツです。後で並べ替えるときに効いてきます
実行すると docs フォルダに4つのPDFができます。
作成: 業務委託契約書.pdf
作成: 請求書_2026-08.pdf
作成: 請求書_2026-09.pdf
作成: 請求書_2026-10.pdf
複数のPDFを1つに結合する(しおり付き)
ここが一番よく使う処理です。docs フォルダの請求書を月の順に並べて、1つのPDFにまとめます。
from pathlib import Path
from pypdf import PdfReader, PdfWriter

folder = Path("docs")
# 請求書だけを月の順に並べる(ファイル名に YYYY-MM を入れておくと並べ替えが楽)
invoices = sorted(folder.glob("請求書_*.pdf"))

writer = PdfWriter()
for pdf in invoices:
    # outline_item を付けると、結合後のPDFに「しおり(目次)」ができる
    writer.append(pdf, outline_item=pdf.stem)
    print(f"追加: {pdf.name}({len(PdfReader(pdf).pages)}ページ)")

out = Path("請求書まとめ_2026.pdf")
with open(out, "wb") as f:
    writer.write(f)

result = PdfReader(out)
print(f"\n結合完了: {out.name}(合計 {len(result.pages)} ページ)")
print("しおり:", [item.title for item in result.outline])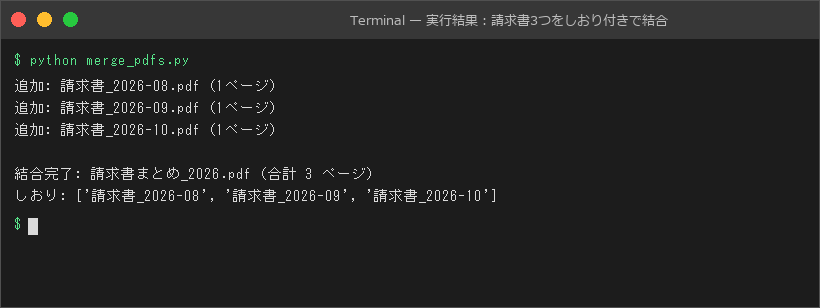
ここが重要です👇
writer.append(pdf)だけで、そのPDFの全ページを末尾に追加できますoutline_item=pdf.stemを付けると、結合後のPDFにしおり(目次)が付きます。PDFビューアのしおり欄に「請求書_2026-08」などが並ぶので、受け取った側が目的の月にすぐ飛べますsorted()で並べているので、ファイル名が「年-月」形式なら古い月から順になります
実行すると、3つの1ページPDFが、しおり付きの3ページのPDFになりました。最後に PdfReader で読み直して、ページ数としおりを確認しているのがポイントです。「ちゃんとできたか」をコードで確かめるクセをつけておくと、自動化したときの事故が減りますよ。
必要なページだけ抜き出す・1ページずつ分割する
次は逆の操作です。4ページの契約書から「本文の2〜3ページ目だけ」を抜き出したり、全ページをバラバラのファイルにしたりします。
from pathlib import Path
from pypdf import PdfReader, PdfWriter

src = Path("docs/業務委託契約書.pdf")
reader = PdfReader(src)
print(f"{src.name}: {len(reader.pages)} ページ")

# ① 必要なページだけ抜き出す(2〜3ページ目=本文)
writer = PdfWriter()
for page in reader.pages[1:3]:   # ⚠️ 0始まりなので「2ページ目」は [1]
    writer.add_page(page)
with open("契約書_本文のみ.pdf", "wb") as f:
    writer.write(f)
print("抜き出し: 契約書_本文のみ.pdf(2ページ)")

# ② 1ページずつ別ファイルに分ける
out_dir = Path("split")
out_dir.mkdir(exist_ok=True)
for i, page in enumerate(reader.pages, start=1):
    one = PdfWriter()
    one.add_page(page)
    name = out_dir / f"{src.stem}_p{i:02d}.pdf"   # p01, p02… と2桁にそろえる
    with open(name, "wb") as f:
        one.write(f)
    print("分割:", name.name)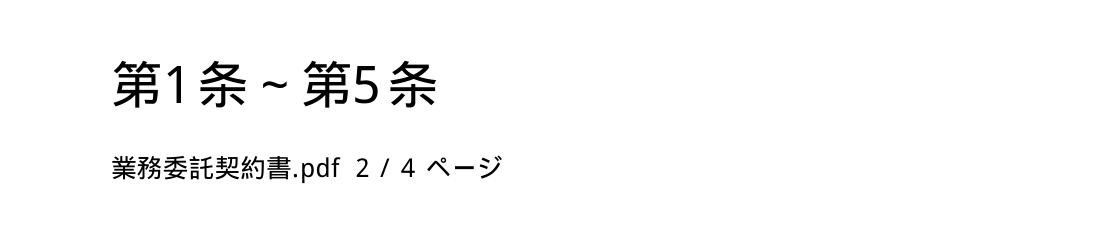
ポイントはこちらです👇
reader.pagesはリストのように扱えるので、reader.pages[1:3]のようにスライスで範囲を指定できます- ⚠️ 番号は0始まりです。人間の「2ページ目」は
[1]、「2〜3ページ目」は[1:3](終わりの3は含まない)になります。ここは一番まちがえやすいところです - 分割したファイル名は
p01、p02… とゼロ埋めの2桁にしています。理由は後半の「つまずきポイント」で説明します
実行結果はこうなりました。
業務委託契約書.pdf: 4 ページ
抜き出し: 契約書_本文のみ.pdf(2ページ)
分割: 業務委託契約書_p01.pdf
分割: 業務委託契約書_p02.pdf
分割: 業務委託契約書_p03.pdf
分割: 業務委託契約書_p04.pdf
これ、実行せずに答えられますか? reader.pages[1:3] で抜き出した 契約書_本文のみ.pdf の1ページ目には、何と書いてあるでしょう?
答えは「第1条〜第5条」(元の2ページ目)です。上の画像のとおり、ページ下の表示も「2 / 4 ページ」になっていて、元のページがそのままコピーされていることが分かります。
PDFにパスワードをかける(AES-256)
請求書や契約書をメールで送るとき、「パスワード付きで」と言われることもありますよね。pypdf なら数行でできます。
from pypdf import PdfReader, PdfWriter

reader = PdfReader("請求書まとめ_2026.pdf")
writer = PdfWriter(clone_from=reader)   # 元のPDFを丸ごとコピー(しおりも残る)

# AES-256 でパスワードをかける(cryptography パッケージが必要)
writer.encrypt(
    user_password="Inv-2026!",          # 開くためのパスワード(取引先に伝える)
    owner_password="Owner-Only-2026",   # 権限変更用(自分だけが持つ)
    algorithm="AES-256",
)
with open("請求書まとめ_2026_保護.pdf", "wb") as f:
    writer.write(f)

# --- ちゃんとかかったか確認 ---
locked = PdfReader("請求書まとめ_2026_保護.pdf")
print("暗号化されている?", locked.is_encrypted)
try:
    locked.pages[0].extract_text()
except Exception as e:
    print("パスワードなしで読むと:", type(e).__name__)

print("decrypt の結果:", locked.decrypt("Inv-2026!").name)
print("1ページ目の文字:", locked.pages[0].extract_text().splitlines()[0])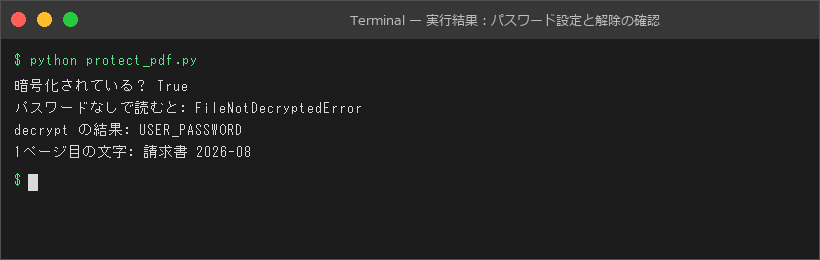
ポイントをまとめるとこんな感じです👇
PdfWriter(clone_from=reader)で、元のPDFをしおりごと丸ごとコピーしてから暗号化しています- user_password は「開くためのパスワード」、owner_password は「権限を変えるためのパスワード」です。owner_password を省略すると user_password と同じものが使われます
algorithm="AES-256"を指定すると強い暗号方式になります。このときcryptographyパッケージが必要です- 暗号化したPDFは
decrypt()するまで中身を読めません。後半で「本当にかかったか」を確認しています
実行すると、パスワードなしで中身を読もうとしたところで FileNotDecryptedError になり、正しいパスワードで decrypt() すると USER_PASSWORD(開く用のパスワードで解除できた)が返ってきました。解除後は1ページ目の文字「請求書 2026-08」もちゃんと読めています。
⚠️ 注意点として、パスワードはコードに直接書きっぱなしにしないようにしましょう。この記事では説明のためにそのまま書いていますが、実際の運用では環境変数や別ファイルから読み込む形がおすすめです。また、PDFとパスワードを同じメールで送ると意味が薄れるので、送り方は取引先のルールに合わせて確認しましょう。
つまずきポイント:ファイルの並び順が「1, 10, 2」になる
結合でよくあるトラブルが、ページの順番がおかしくなることです。原因の多くはファイル名の並べ替えにあります。
import re

files = ["見積書_1.pdf", "見積書_2.pdf", "見積書_10.pdf", "見積書_3.pdf"]

# そのまま sorted すると「文字」として比べるので 10 が 2 より前に来る
print("sorted のまま:", sorted(files))

def natural_key(name):
    """'見積書_10.pdf' → ['見積書_', 10, '.pdf'] のように数字部分を int にする"""
    return [int(t) if t.isdigit() else t for t in re.split(r"(\d+)", name)]

print("自然順       :", sorted(files, key=natural_key))
sorted のまま: ['見積書_1.pdf', '見積書_10.pdf', '見積書_2.pdf', '見積書_3.pdf']
自然順 : ['見積書_1.pdf', '見積書_2.pdf', '見積書_3.pdf', '見積書_10.pdf']つまり、sorted() はファイル名を文字として先頭から1文字ずつ比べるので、「1」の次に「10」が来てしまうんです。これだと見積書_10 が2番目に結合されてしまいますよね。
対策は2つあります。
- ファイル名をゼロ埋めする:
見積書_01.pdf、見積書_02.pdf… にしておけば、普通のsorted()でも正しく並びます(分割のコードでp01にしたのはこのためです) - 自然順で並べる:すでにある名前を変えられないときは、上の
natural_keyのように数字部分を int に変換して比べます。結合のコードのsorted(...)をsorted(..., key=natural_key)に変えるだけで使えます
日付を入れるなら 2026-08 のように「年-月」をゼロ埋めした形にしておくのが一番ラクです。最初のサンプルでこの形にしたのはそのためです😊
実務で使うときのヒント
- 元ファイルは上書きしない:この記事のコードは、すべて新しいファイル名で書き出しています。自動化では「元のファイルは残す」が基本です
- 処理後に読み直して確認する:ページ数・しおり・暗号化の有無を
PdfReaderでチェックしておくと安心です - スキャンしたPDFは文字が取れない:
extract_text()で文字が読めるのは、文字情報を持ったPDFだけです。紙をスキャンした画像だけのPDFでは空になることがあります(結合・分割・暗号化はできます) - 毎月の定型作業にする:「docsフォルダに置いて実行するだけ」の形にしておけば、月末の作業がコマンド1回で終わります
ほかの機能は pypdf 公式ドキュメント にまとまっています。
まとめ
今回は、pypdf を使ったPDFの定番作業を一通り自動化しました。
- 結合:
PdfWriterのappend()で追加するだけ。outline_itemでしおりも付く(PdfMergerは削除済み) - 抜き出し・分割:
reader.pagesをスライスしてadd_page()。番号は0始まりに注意 - パスワード:
encrypt(..., algorithm="AES-256")。cryptographyが必要 - 並び順:ファイル名はゼロ埋めか「年-月」形式に。変えられないなら自然順ソート
どれも自分のPCの中だけで完結するので、外に出したくない書類でも安心して扱えます。「毎月なんとなく手でやっていた作業」を、ぜひ1つPythonに任せてみてください🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR