scikit-learnのGridSearchCV入門!k近傍法のkを交差検証で選んでテストデータでだまされない方法
「k近傍法のkって、結局いくつにすればいいの?」「とりあえずいくつか試して、テストの点がいちばん高いものを選べばいいですよね?」
機械学習を始めると、こういうモデルの設定値(ハイパーパラメータ)の決め方で迷いますよね。じつは「テストデータで点数を見ながら選ぶ」のは、やってはいけない選び方なんです⚠️
この記事では、scikit-learnのGridSearchCVを使って、設定値の候補を総当たりで比べ、テストデータを最後まで取っておく正しい手順を一緒に見ていきましょう!
対象:scikit-learnで fit と score を使ったことがある初〜中級者。コードはすべて手元で実行し、出た結果をそのまま載せています(scikit-learn 1.9.0)。
ハイパーパラメータとは?k近傍法のkで考える
k近傍法(KNeighborsClassifier)は、「新しいデータにいちばん近いk件を見て、多数決でクラスを決める」シンプルな分類方法です。イメージとしては「近所の人に聞いて決める」感じですね。
- kが小さい:すぐ隣の1〜2件に振り回されやすい
- kが大きい:遠くのデータまで多数決に混ざって、境目がぼやける
このkのように、学習の前に人が決める設定値をハイパーパラメータと呼びます。データから自動で学ぶ値(重みなど)とは別物です。
題材には、scikit-learnに入っているワインの成分データ(178本・13項目・3品種)を使います。ダウンロード不要なので、そのまま試せます😊
まずはダメな例:テストの点数を見ながらkを選ぶ
ありがちなのが、次のように「kを変えてテスト正解率を比べる」やり方です。
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier

# ワインの成分データ(178本・13項目・3品種)
X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)

# k(近所を何件見るか)を変えて、テストデータの正解率を比べる
for k in [1, 3, 5, 7, 9, 15]:
    model = KNeighborsClassifier(n_neighbors=k)
    model.fit(X_train, y_train)
    score = model.score(X_test, y_test)
    print(f"k={k:2d}  テスト正解率: {score:.3f}")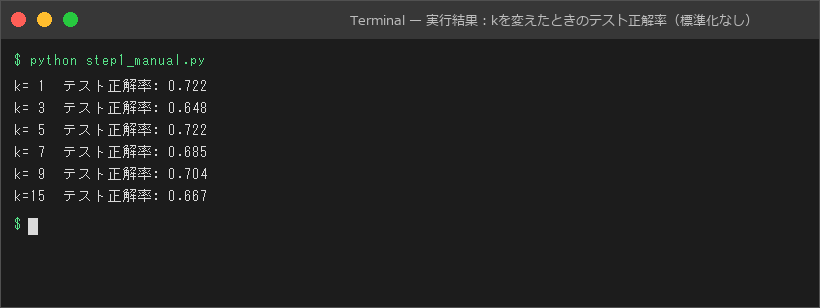
実行するとこうなりました👇
- k=1 と k=5 がどちらも 0.722 でトップ、k=3 は 0.648
- 正解率は全体的に 0.65〜0.72 と低め
ここで「じゃあk=5で!」と決めると、問題が2つあります。
- テストデータに合わせて選んでしまっている:テストデータは「まだ見たことのないデータでどれくらい当たるか」を測るためのもの。それを見ながら選ぶと、たまたまテストに合う設定を選んだだけかもしれず、正解率が実力より良く見えてしまいます。
- 標準化をしていない:ワインのデータは項目ごとに数値の大きさがバラバラ(プロリンは数百〜千以上、色合いは1前後など)。k近傍法は「距離」で近所を決めるので、大きな数値の項目だけで距離が決まってしまいます。
これ、どちらも初めのうちはやりがちなんですよね。
GridSearchCVで「訓練データの中だけ」で選ぶ
そこでGridSearchCVの出番です。やってくれることは、つまり次の3つです。
- 候補の組み合わせを全部(グリッド状に)試す
- それぞれを訓練データだけを使った交差検証で採点する(訓練データを5つに分け、4つで学習・1つで採点を5回くり返して平均)
- いちばん良かった設定で、訓練データ全体を使って学習し直す
標準化もPipelineでまとめておくと、交差検証の分割ごとに正しく標準化してくれます。
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)

# 標準化 → k近傍法 を1つのモデルとしてまとめる
pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("knn", KNeighborsClassifier()),
])

# 試したい設定の組み合わせ(「部品名__引数名」で指定する)
param_grid = {
    "knn__n_neighbors": list(range(1, 31)),
    "knn__weights": ["uniform", "distance"],
}

# 訓練データだけを5分割して、30×2=60通りを交差検証で比べる
grid = GridSearchCV(pipe, param_grid, cv=5, scoring="accuracy")
grid.fit(X_train, y_train)

print("試した組み合わせ:", len(grid.cv_results_["params"]), "通り")
print("いちばん良かった設定:", grid.best_params_)
print(f"交差検証の平均正解率: {grid.best_score_:.3f}")

# テストデータは最後に1回だけ使う
print(f"テスト正解率(最後に1回だけ): {grid.score(X_test, y_test):.3f}")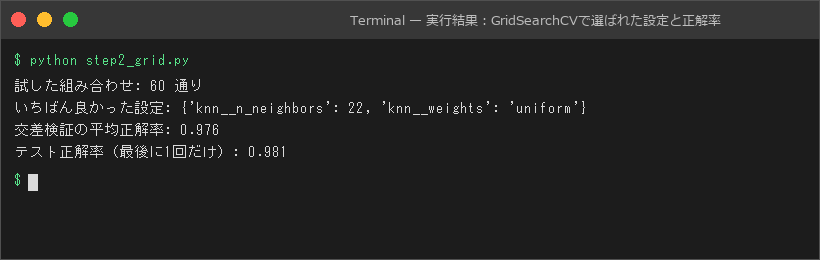
ここが重要です👇
- Pipelineの中の設定は
"knn__n_neighbors"のように「部品名__引数名」(アンダースコア2つ)で指定する weightsは"uniform"(k件を同じ重みで多数決)と"distance"(近いデータほど重く数える)の2種類grid.fitに渡すのは訓練データだけ。テストデータは最後のgrid.scoreで1回だけ使う
結果は、60通りの中から k=22・uniform が選ばれ、交差検証の平均正解率は 0.976、最後に1回だけ測ったテスト正解率は 0.981 でした。標準化なしで手作業で選んだときの 0.722 から大きく上がっています🚀
交差検証の点数とテストの点数が近いので、「選び方がテストデータに引っぱられていない」ことも確認できますね。
結果を全部見てみよう:1位は11通りもあった
「k=22がベストなんだ!」と思いたくなりますが、ちょっと待ってください。これ、実行せずに答えられますか?「同じ点数の1位がほかにもあったら、GridSearchCVはどれを選ぶ?」
cv_results_ をpandasの表にして、kごとの平均正解率をグラフにしてみます。
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

plt.rcParams["font.family"] = "Meiryo"  # 日本語ラベル用(Windows)

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)
pipe = Pipeline([("scaler", StandardScaler()), ("knn", KNeighborsClassifier())])
param_grid = {"knn__n_neighbors": list(range(1, 31)),
              "knn__weights": ["uniform", "distance"]}
grid = GridSearchCV(pipe, param_grid, cv=5, scoring="accuracy")
grid.fit(X_train, y_train)

# 全60通りの結果を表にする
results = pd.DataFrame(grid.cv_results_)
cols = ["param_knn__n_neighbors", "param_knn__weights",
        "mean_test_score", "std_test_score", "rank_test_score"]
top = results[cols].sort_values("rank_test_score").head(5)
print(top.round(3).to_string(index=False))
print("1位タイの組み合わせ:", (results["rank_test_score"] == 1).sum(), "通り")

# kごとの平均正解率をグラフにする
for w, label in [("uniform", "uniform(同じ重み)"), ("distance", "distance(近いほど重く)")]:
    part = results[results["param_knn__weights"] == w]
    plt.plot(part["param_knn__n_neighbors"], part["mean_test_score"],
             marker="o", label=label)
plt.xlabel("k(近所を何件見るか)")
plt.ylabel("交差検証の平均正解率")
plt.title("GridSearchCVの結果:kと正解率")
plt.legend()
plt.grid(alpha=0.3)
plt.show()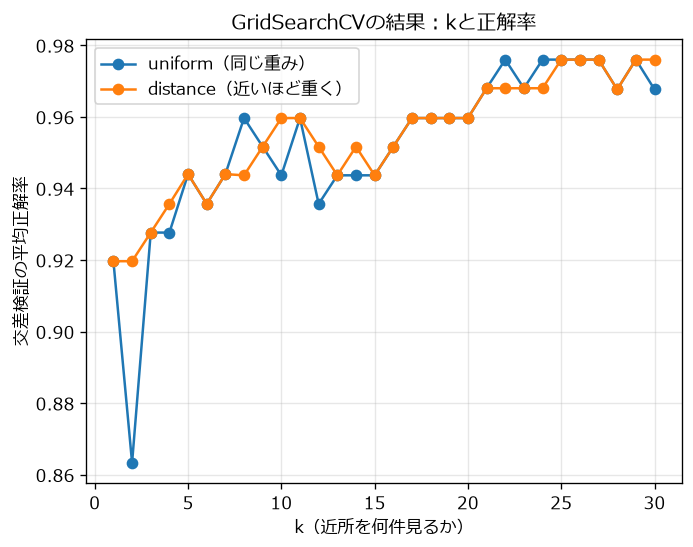
表の上位を見ると、平均正解率 0.976 で並ぶ1位タイが11通りありました(k=22, 24〜27, 29, 30 あたり)。
| k | weights | 平均正解率 | 順位 |
|---|---|---|---|
| 30 | distance | 0.976 | 1 |
| 25 | distance | 0.976 | 1 |
| 26 | uniform | 0.976 | 1 |
| 26 | distance | 0.976 | 1 |
| 27 | uniform | 0.976 | 1 |
同点のときは、候補を試した順番でいちばん先に出てきたものが best_params_ になります。今回は k=1 から順に試しているので、1位タイの中でkが最も小さい22が選ばれた、というわけです。
グラフから読み取れるポイントをまとめるとこんな感じです👇
- k=1〜5 あたりは正解率が低め(すぐ隣のデータに振り回されている)
- k=20を超えるあたりから 0.96〜0.976 で横ばい
- uniformとdistanceの差は小さい
つまり「k=22が特別に良い」のではなく、「kは20台ならどれでもだいたい同じ」というのが実際のところです。訓練データは124件しかないので、5分割した1回分の採点は約25件。1件当たるか外れるかで0.04ほど変わるため、細かい差を気にしすぎないことも大切です。
GridSearchCVを使うときの注意点
- 組み合わせ数×分割数だけ学習が走る:今回は60通り×5分割=300回。候補を増やしすぎると時間がかかるので、最初は粗く(例:1, 5, 10, 20…)探してから、良さそうな範囲を細かく探すのがおすすめです。
- 前処理はPipelineに入れる:標準化を先に全データでやってからGridSearchCVに渡すと、採点用のデータの情報まで標準化に混ざってしまいます。
- テストデータは最後に1回:テストの点を見てから候補を変えてやり直すと、結局テストデータで選んでいるのと同じになります。
公式ドキュメント:sklearn.model_selection.GridSearchCV
まとめ
- kのようなハイパーパラメータを、テストデータの点数を見ながら選ぶのはNG
- GridSearchCVなら、訓練データの中の交差検証だけで候補を総当たりで比べられる
- 標準化はPipelineに入れ、設定は「部品名__引数名」で指定する
- 今回は正解率が 0.722(標準化なし・手作業)→ 0.981(標準化あり・GridSearchCV)に
cv_results_を表やグラフで見ると、1位タイが多いことや「だいたいこの範囲なら同じ」がわかる
「ハイパーパラメータ調整ってむずかしそう」が「できそう」に変わったらうれしいです。手元のデータでも、ぜひ試してみてください😊
こちらも読まれています
📡 Arduinoをもっと深く学ぼう!
Arduino・ラズパイ・ロボットプログラミングを体系的に学びたい方へ。おすすめのUdemyコースや電子部品もまとめています。
Arduinoロボット入門のおすすめコース・部品を見る →📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR