Python×scikit-learnで家計簿の支出を自動分類!カード明細を「食費・交通費…」に仕分けるAI入門
「家計簿アプリの自動分類、いまいち当たらなくて結局手で直してるんですよね…」
カードの明細を見ながら「これは食費、これは交通費…」と仕分ける作業、地味に面倒ですよね。そこで今回は、自分の明細データで学習する「自分専用の支出分類AI」をPythonで作ってみます。
使うのは定番の機械学習ライブラリ scikit-learn。難しい数式は出てきません。Pythonの基本がわかる初心者〜初級者の方なら、コピペで動かしながらざっくりとした流れがつかめるはずです。一緒に見ていきましょう!
今回作るものと仕組み
作るのは、明細の「摘要」(例:セブンイレブン 品川店)を入力すると、「食費」「交通費」「光熱費」「サブスク」「日用品・衣類」のどれかを答えてくれる分類器です。
仕組みは2段階です。
- TF-IDFで、文章を「どんな文字の並びがどれくらい特徴的に含まれるか」という数値のリストに変換する
- ロジスティック回帰で、その数値からカテゴリを予測する
イメージとしては、「『イレブン』『ローソ』みたいな文字の並びが入っていたら食費っぽい」というルールを、データから自動で学んでくれる感じです。
事前に次のライブラリを入れておきましょう。
pip install scikit-learn pandas joblib
STEP1:明細データで学習して分類してみる
まずは少しのデータで学習させて、学習に使っていない明細を分類してみます。
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline

# 学習データ(明細の摘要, カテゴリ)
data = [
    ("セブンイレブン 渋谷店", "食費"), ("ローソン 新宿西口", "食費"),
    ("ファミリーマート 池袋", "食費"), ("イオン 食品売場", "食費"),
    ("マクドナルド 駅前店", "食費"), ("すき家 本町店", "食費"),
    ("JR東日本 モバイルSuica", "交通費"), ("東京メトロ 定期券", "交通費"),
    ("タクシー 日本交通", "交通費"), ("ENEOS 給油", "交通費"),
    ("東京電力 電気料金", "光熱費"), ("東京ガス ガス料金", "光熱費"),
    ("水道局 上下水道料金", "光熱費"),
    ("Netflix 月額", "サブスク"), ("Spotify Premium", "サブスク"),
    ("Amazonプライム 年会費", "サブスク"), ("YouTube Premium", "サブスク"),
    ("ユニクロ 銀座店", "日用品・衣類"), ("無印良品 有楽町", "日用品・衣類"),
    ("マツモトキヨシ 渋谷", "日用品・衣類"), ("ダイソー 高田馬場", "日用品・衣類"),
]
texts = [t for t, _ in data]
labels = [c for _, c in data]

# 文字2〜3グラムでTF-IDF化 → ロジスティック回帰
model = make_pipeline(
    TfidfVectorizer(analyzer="char_wb", ngram_range=(2, 3)),
    LogisticRegression(C=10, max_iter=1000),
)
model.fit(texts, labels)

# 学習に使っていない明細で試す
tests = ["セブンイレブン 品川店", "東京メトロ 回数券", "Netflix 追加料金",
         "ユニクロ 新宿店", "東京電力 基本料金", "スターバックス 表参道"]
for t, pred in zip(tests, model.predict(tests)):
    print(f"{t:<16} → {pred}")
ここが重要です👇
analyzer="char_wb",ngram_range=(2, 3)で、2〜3文字ずつの並びを特徴にしている- 日本語は英語のように単語がスペースで区切られていないので、文字単位で見ると形態素解析なしでも扱える
make_pipelineで「変換 → 予測」を1つのモデルにまとめているので、predict()に文字列をそのまま渡せるC=10は「学習データにどれくらい強く合わせるか」の設定。今回のようにデータが少ないと、既定値(C=1)では確率が全体的に低く出がちなので大きめにしている
実行すると、次のように分類されました。
| 明細(学習に使っていないもの) | 予測されたカテゴリ |
|---|---|
| セブンイレブン 品川店 | 食費 |
| 東京メトロ 回数券 | 交通費 |
| Netflix 追加料金 | サブスク |
| ユニクロ 新宿店 | 日用品・衣類 |
| 東京電力 基本料金 | 光熱費 |
| スターバックス 表参道 | 食費 |
学習に使っていない「品川店」「回数券」なども、ちゃんと正しいカテゴリに分類できています。
ただ、ちょっと気になるのが最後の行です。「スターバックス 表参道」が食費になっています。今回はたまたま合っていますが、学習データにスターバックスは1件も入っていません。本当に自信を持って当てたのでしょうか?
STEP2:自信がない明細は「要確認」に回す
機械学習のモデルは、わからないものでも何かしらのカテゴリを必ず答えてしまいます。家計簿でこれが起きると、間違ったカテゴリのまま集計されてしまいますよね。
そこで predict_proba() で各カテゴリの確率(確信度)を見て、低いものは「要確認」として人がチェックする仕組みにします。STEP1のコードの続きに追記してください。
THRESHOLD = 0.5  # 確信度がこれ未満なら「要確認」に回す

for t, probs in zip(tests, model.predict_proba(tests)):
    best = probs.argmax()          # 一番確率が高いカテゴリの番号
    label = model.classes_[best]
    conf = probs[best]
    if conf < THRESHOLD:
        label = "要確認"
    print(f"{t:<16} → {label}(確信度 {conf:.2f})")
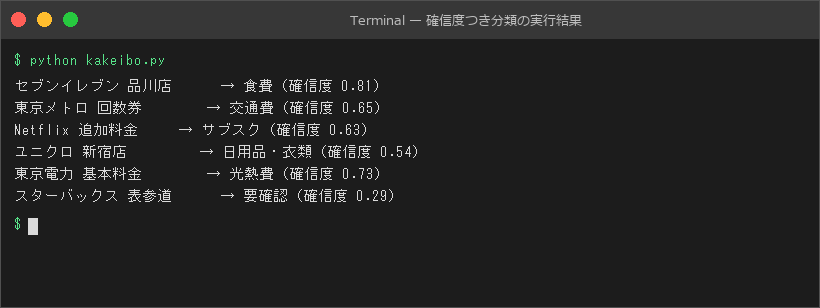
predict_proba()は、カテゴリごとの確率を返す(1行の合計が1になる)model.classes_に、確率の並び順に対応するカテゴリ名が入っている- しきい値(今回は0.5)を上げるほど、「要確認」が増えるかわりに誤分類が減る
学習データにあるお店の明細は確信度0.5以上になり、未知のスターバックスは0.29で「要確認」に回りました。「わからないものはわからないと言わせる」のが、実用で使うときの大事なポイントです。
STEP3:CSVの明細を一括分類して集計する
最後に、明細CSVを読み込んで一括で分類し、カテゴリ別の合計まで出してみます。これもSTEP1の続きに書いてください。
import joblib
import pandas as pd

# ---- 練習用の明細CSVを作る(実際はカード会社などからダウンロードしたCSVを使う)----
pd.DataFrame({
    "日付": ["2026/09/01", "2026/09/02", "2026/09/03", "2026/09/05", "2026/09/06"],
    "摘要": ["ローソン 渋谷", "JR東日本 モバイルSuica", "Spotify Premium",
             "無印良品 池袋", "ドトール 新橋"],
    "金額": [648, 3000, 1080, 2490, 420],
}).to_csv("meisai.csv", index=False, encoding="utf-8-sig")

# ---- 学習済みモデルを保存 → 読み込み(次回からは学習し直さなくてよい)----
joblib.dump(model, "kakeibo_model.joblib")
model = joblib.load("kakeibo_model.joblib")

# ---- CSVを読み込んで一括分類 ----
df = pd.read_csv("meisai.csv", encoding="utf-8-sig")
probs = model.predict_proba(df["摘要"])
df["カテゴリ"] = model.classes_[probs.argmax(axis=1)]
df["確信度"] = probs.max(axis=1).round(2)
df.loc[df["確信度"] < 0.5, "カテゴリ"] = "要確認"

print(df)
print()
print(df.groupby("カテゴリ")["金額"].sum())
df.to_csv("meisai_classified.csv", index=False, encoding="utf-8-sig")
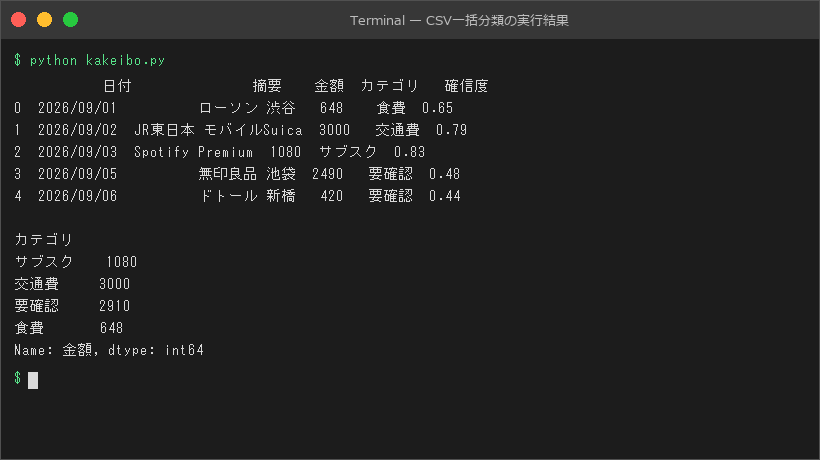
joblib.dump()で学習済みモデルをファイルに保存でき、次回からはjoblib.load()で読み込むだけencoding="utf-8-sig"で保存すると、Excelで開いても文字化けしにくい- 「要確認」になった明細は、自分でカテゴリを付けて学習データに追加していく
実行すると、未知の「無印良品 池袋」と「ドトール 新橋」が要確認になりました。無印良品は学習データに「無印良品 有楽町」がありますが、店名部分が違うため確信度が0.48とわずかに届きませんでした。こうした明細を正しいカテゴリで学習データに追加していくと、使うほど自分の明細に強いモデルに育っていきます。
精度を上げるためのヒント
- 学習データを増やす:最低でも各カテゴリ20〜30件あると安定しやすい。過去数か月分の明細に手でカテゴリを付けて使うのがおすすめ
- カテゴリごとの件数をそろえる:食費だけ極端に多いと、迷ったときに食費を選びやすくなる
- 精度を数字で確認する:データが増えてきたら
train_test_splitでテスト用データを分けて、正解率を測りながら改善する
まとめ
今回は、scikit-learnで家計簿の支出を自動分類するAIを作りました。ポイントは3つです。
- 日本語の短い文は文字n-gramのTF-IDFで、形態素解析なしでも扱える
predict_proba()で確信度を見て、低いものは「要確認」に回す- 要確認の明細を学習データに足していけば、使うほど賢くなる
「機械学習ってむずかしそう」と思っていた方も、実際に書いたのは数十行です。ぜひ自分の明細データで試してみてください。「当たった!」という感覚が、次のステップへの一番の燃料になりますよ🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR