Python×LangChainでCLIエージェントを自作!ツール呼び出し・会話メモリ・エージェントループを一から実装
「AIエージェントって結局どういう仕組みで動いてるの?」
フレームワークを使えば数行で作れる、という記事は増えましたが、中身がブラックボックスのままだと応用が効かないんですよね。
そこで今回は、ターミナルで動くCLIエージェントをLangChainでゼロから組み立てていきます。ポイントは3つだけ。①会話ループ、②ツール呼び出し、③メモリ管理。この3つが分かれば、エージェントの正体はけっこうシンプルだと気づけるはずです 🚀
この記事の対象と難易度
- 対象:Pythonの関数・辞書・while文が読める初〜中級者
- 難易度:★★☆☆☆(LLM APIを触ったことがなくてもOK)
- ゴール:ツールを呼びながら会話し続けるCLIアプリを自作する
- 所要時間:30〜40分
そもそもエージェントって何をしてるの?
イメージとしては、「LLMに道具箱を渡して、使い終わるまで待つループ」です。
- ユーザーの発言を履歴に追加する
- LLMに履歴と「使える道具の一覧」を渡す
- LLMが「この道具を使いたい」と言ったら、Python側で実際に実行する
- 実行結果を履歴に戻して、もう一度LLMに聞く
- 道具が不要になったら、最終回答を表示する
つまりエージェント=for文で回る会話。魔法ではありません。ここが腑に落ちると一気に自作できるようになります。
STEP0:環境を準備する
pip install langchain-core langchain-anthropic tzdata

# Windows (PowerShell)
setx ANTHROPIC_API_KEY "sk-ant-xxxxxxxx"

# macOS / Linux
export ANTHROPIC_API_KEY="sk-ant-xxxxxxxx"APIキーはコードに直書きしないのが鉄則です。環境変数に入れておきましょう。設定後はターミナルを開き直すのを忘れずに。
STEP1:いちばん小さな会話ループを作る
まずはツールなしで、「入力→応答→履歴に積む」だけのループを書きます。ここが全部の土台になります。
# chat_loop.py
import os
from langchain_anthropic import ChatAnthropic
from langchain_core.messages import SystemMessage, HumanMessage

llm = ChatAnthropic(model="claude-opus-5", max_tokens=4096)

# 会話履歴。先頭のSystemMessageがエージェントの「人格」になる
messages = [SystemMessage(content="あなたは日本語で簡潔に答えるCLIアシスタントです。")]


def to_text(content):
    """応答本文をテキストとして取り出す(thinkingブロック混在に対応)"""
    if isinstance(content, str):
        return content
    return "".join(b.get("text", "") for b in content if b.get("type") == "text")


print("CLIエージェント起動(exitで終了)")
while True:
    user_input = input("\nあなた> ").strip()
    if user_input in ("exit", "quit"):
        print("またね!")
        break
    if not user_input:
        continue

    messages.append(HumanMessage(content=user_input))
    ai = llm.invoke(messages)
    messages.append(ai)  # AIMessageはそのまま積むのがコツ
    print(f"AI> {to_text(ai.content)}")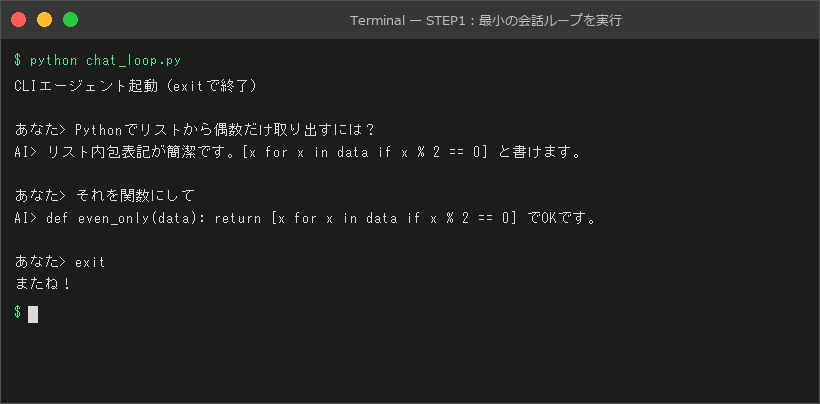
ここが重要です。ポイントをまとめるとこんな感じ。
- messagesリストそのものが「記憶」。毎回まるごと送るから文脈が続く
- 応答は
str(ai.content)ではなくブロックからtextだけ抽出する(思考ブロックが混ざるモデルで事故りやすい) - AIの発言は文字列に変換せずAIMessageオブジェクトのまま積む。後のツール呼び出しで必須になります
STEP2:ツール呼び出しを足してエージェント化する
LangChainでは@toolデコレータを付けるだけで関数がツールになります。docstringがそのままLLMへの説明文になるので、ここは日本語で丁寧に書きましょう。
# tools_agent.py
import datetime
from pathlib import Path
from zoneinfo import ZoneInfo
from langchain_core.tools import tool
from langchain_core.messages import ToolMessage
from langchain_anthropic import ChatAnthropic


@tool
def now_jst() -> str:
    """現在の日時(日本時間)を取得する。日付や時刻を聞かれたら必ずこれを使う。"""
    # now() だけだと実行環境のローカルタイムになるのでタイムゾーンを明示する
    return datetime.datetime.now(ZoneInfo("Asia/Tokyo")).strftime("%Y-%m-%d %H:%M:%S")


@tool
def calc(expression: str) -> str:
    """四則演算を計算する。expressionには '12*34+5' のような式を渡す。"""
    allowed = set("0123456789+-*/(). ")
    if not set(expression) <= allowed:
        return "エラー: 使用できない文字が含まれています"
    try:
        return str(eval(expression))  # 文字種を制限した上で実行
    except Exception as e:
        # 不正な式('1+' など)やゼロ除算で落とさない
        return f"エラー: 計算できませんでした({e})"


@tool
def read_head(path: str) -> str:
    """テキストファイルの先頭300文字を読み込む。ファイル内容を聞かれたら使う。"""
    p = Path(path)
    if not p.is_file():
        return f"エラー: {path} が見つかりません"
    try:
        return p.read_text(encoding="utf-8")[:300]
    except Exception as e:
        # バイナリファイル等で例外を投げないようにする
        return f"エラー: 読み込みに失敗しました({e})"


TOOLS = [now_jst, calc, read_head]
TOOL_MAP = {t.name: t for t in TOOLS}

llm = ChatAnthropic(model="claude-opus-5", max_tokens=4096).bind_tools(TOOLS)


def run_agent(messages, max_steps=5):
    """ツール呼び出しが尽きるまで回すエージェントループ"""
    for step in range(max_steps):
        ai = llm.invoke(messages)
        messages.append(ai)

        if not ai.tool_calls:      # 道具が不要=最終回答
            return ai

        for call in ai.tool_calls:
            print(f"  [tool] {call['name']}({call['args']})")
            result = TOOL_MAP[call["name"]].invoke(call["args"])
            messages.append(
                ToolMessage(content=str(result), tool_call_id=call["id"])
            )
    return ai  # 上限に達した場合の保険
実装の勘どころはこの3点です。
- ToolMessageには必ずtool_call_idを付ける。これがないと「どの呼び出しへの答えか」が対応付かずエラーになります
- max_stepsで上限を切る。無限ループ=APIコスト無限なので、保険は必須です 💸
- ツールは例外を投げずに文字列でエラーを返す。LLMが読んでリカバリーしてくれます(=ツール内部はtry/exceptで包む)
STEP3:メモリ管理でトークン爆発を防ぐ
履歴を積みっぱなしにすると、10往復もすれば入力トークンがどんどん膨らみます。そこで「システムメッセージは残し、古い会話から捨てる」トリミングを入れます。
# cli_agent.py(完成版・抜粋)
from langchain_core.messages import SystemMessage, HumanMessage
from tools_agent import run_agent

SYSTEM = SystemMessage(content=(
    "あなたはターミナル上で動くアシスタントです。"
    "計算・日時・ファイル確認はツールを使い、推測で答えないでください。"
))


def trim(messages, keep=12):
    """直近keep件だけ残す。ただし途中のツール応答で切らないよう調整"""
    head, rest = messages[0], messages[1:]
    if len(rest) <= keep:
        return messages
    rest = rest[-keep:]
    # 先頭がHumanMessageになるまで削り、会話の切れ目を揃える
    while rest and not isinstance(rest[0], HumanMessage):
        rest.pop(0)
    return [head] + rest


def to_text(content):
    if isinstance(content, str):
        return content
    return "".join(b.get("text", "") for b in content if b.get("type") == "text")


def main():
    messages = [SYSTEM]
    print("CLIエージェント起動(/reset で履歴クリア、exit で終了)")
    while True:
        user_input = input("\nあなた> ").strip()
        if user_input in ("exit", "quit"):
            print("またね!")
            break
        if user_input == "/reset":
            messages = [SYSTEM]
            print("履歴をクリアしました 🧹")
            continue
        if not user_input:
            continue

        messages.append(HumanMessage(content=user_input))
        messages = trim(messages, keep=12)
        ai = run_agent(messages)
        print(f"AI> {to_text(ai.content)}")


if __name__ == "__main__":
    main()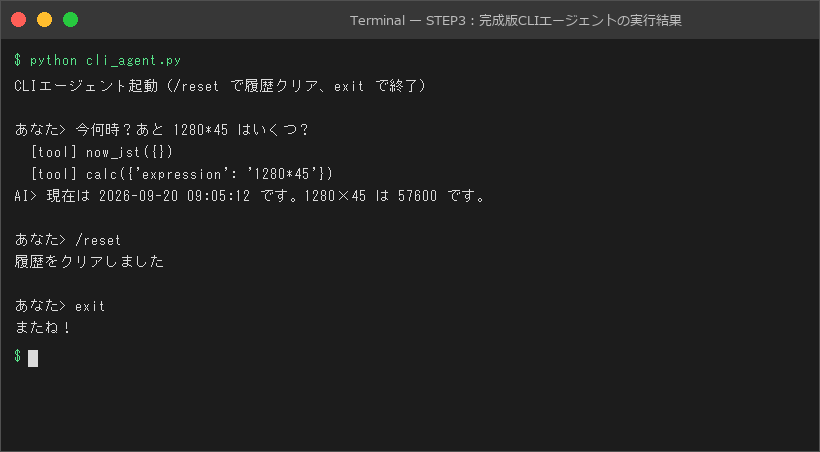
トリミングでやってはいけないのが「AIMessage(tool_calls付き)とToolMessageを分断すること」。ペアが崩れるとAPIがエラーを返します。先頭をHumanMessageに揃えるだけで、この事故はほぼ防げます ✅
つまずきやすいポイント3選
1. ツールが呼ばれない
docstringが曖昧なケースがほとんどです。「いつ使うか」まで書きましょう。「現在の日時を取得する」より「日付や時刻を聞かれたら必ずこれを使う」のほうが確実に効きます。
2. 応答が空文字になる
contentがリスト形式で返るケースです。STEP1のto_text()のようにtype=”text”のブロックだけ拾う処理を必ず挟んでください。
3. 会話が長くなると急に遅い・高い
履歴の肥大化が原因。trim()のkeep値を調整するか、古い履歴をLLMに要約させて1件のSystemMessageに畳む「要約メモリ」にステップアップするのもおすすめです。
まとめ
CLIエージェントの正体は、「履歴リスト+ツール実行+while/forループ」という、驚くほど素朴な組み合わせでした。フレームワークに任せきりにせず一度自分で書いておくと、動かないときにどこを見ればいいかが分かるようになります。
次の一歩としては、ツールにWeb検索やSQLクエリを追加したり、履歴をJSONで保存してセッションを復元したりするのが面白いところ。ぜひ自分専用の道具箱を育ててみてください。「むずかしそう」が「できそう」に変わるはずです 💡
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR