scikit-learnのIsolationForest入門!カード利用履歴から「いつもと違う」利用を見つける
「クレジットカードの明細、なんとなく眺めているけど、もし不正利用されていたら気づける自信がない…」
「異常検知ってよく聞くけど、平均から離れた値を探すのとどう違うの?」
こんなふうに思ったこと、ありますよね。
この記事では、scikit-learn の IsolationForest(アイソレーション・フォレスト)を使って、カードの利用履歴から「いつもと違う使われ方」を見つける異常検知を体験します。対象は、Python の基本(pandas で表を読む程度)がわかる初〜中級者の方です。
ポイントは、「1つ1つの値はふつうなのに、組み合わせが変」という異常です。よく使われる Z-score(平均から標準偏差いくつ分離れているか)では見逃してしまうケースを、実際にコードを動かして確かめていきます。一緒に見ていきましょう!🚀
IsolationForestってどんな仕組み?
イメージとしては、「ランダムに線を引いて、データを1件ずつ孤立させるゲーム」です。
- データの散らばっている範囲に、ランダムに区切り線を引いていく
- みんなと離れた場所にいるデータは、少ない回数の区切りで1件だけ取り残される
- 群れの中にいるデータは、なかなか1件だけにならない
つまり、「すぐ孤立する=異常っぽい」と判定する方法です。この区切りを木(決定木のようなもの)でたくさん作って平均をとるので「フォレスト(森)」という名前がついています。
正解ラベル(これは不正、これは正常)がなくても使えるのが大きな特徴です。実際の明細には「不正」のラベルなんて付いていないので、ここがうれしいところですよね😊
練習用のカード利用履歴をつくる
本物の明細は使えないので、「ある人のふだんの使い方」を乱数で再現します。設定はこんな感じです👇
- 昼〜夕方(10〜20時):日用品やランチ(300〜5,000円)が150件
- 昼(11〜18時):家電や服などの大きめの買い物(1万〜3万円)が20件
- 夜遅く(22〜23時):コンビニの少額だけ(200〜1,500円)が30件
そこに「あやしい利用」を4件まぜます。うち2件は夜23時に22,000円、22時に18,000円です。夜遅くに使うこと自体はよくあるし、2万円前後の買い物も昼ならよくある。でも、「夜遅くに2万円」はこの人にとって初めて、というデータです。
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)

def block(n, h_lo, h_hi, a_lo, a_hi):
    # 時刻 h_lo〜h_hi 時、金額 a_lo〜a_hi 円の利用を n 件つくる
    return pd.DataFrame({
        "hour": rng.integers(h_lo, h_hi + 1, n),
        "amount": (rng.uniform(a_lo, a_hi, n) / 10).round().astype(int) * 10,
    })

normal = pd.concat([
    block(150, 10, 20, 300, 5000),     # 昼〜夕方の日用品・ランチ
    block(20, 11, 18, 10000, 30000),   # 昼の大きめの買い物(家電・服)
    block(30, 22, 23, 200, 1500),      # 夜遅くのコンビニ(少額だけ)
])
normal["label"] = "ふだん"

odd = pd.DataFrame({
    "hour":   [12, 3, 23, 22],
    "amount": [98000, 45000, 22000, 18000],
    "label":  "あやしい",
})

df = pd.concat([normal, odd], ignore_index=True)
df.to_csv("card_log.csv", index=False)
print(df.shape)  # (204, 3)
このコードを実行すると、作業フォルダに card_log.csv(204件)ができます。hour が利用時刻、amount が金額、label は答え合わせ用の列です(モデルには渡しません)。
まずはZ-scoreで探してみる
比較のために、よく使われる Z-score で異常を探してみます。列ごとに「平均からどれだけ離れているか」を計算し、どちらかが 3 を超えたら異常とする、定番のやり方です。
import pandas as pd

df = pd.read_csv("card_log.csv")

# 列ごとに Z-score(平均から標準偏差いくつ分離れているか)を計算
for col in ["hour", "amount"]:
    z = (df[col] - df[col].mean()) / df[col].std()
    df[f"z_{col}"] = z.abs()

# どちらかの列で |Z| > 3 なら「異常」とする
df["z_alert"] = (df["z_hour"] > 3) | (df["z_amount"] > 3)

print(df[df["label"] == "あやしい"][["hour", "amount", "z_hour", "z_amount", "z_alert"]].round(2))
print("Z-scoreで異常判定された件数:", df["z_alert"].sum())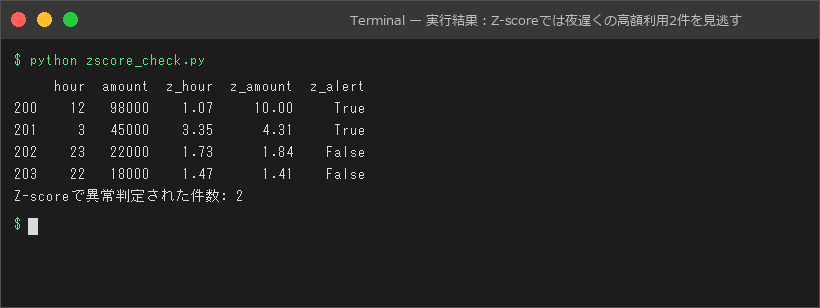
これ、実行せずに結果を予想できますか? 実際に動かすと、あやしい4件のうち z_alert が True になるのは2件だけで、最後に「Z-scoreで異常判定された件数: 2」と表示されました。
ここが重要です👇
- 12時の98,000円、3時の45,000円のような「値そのものが極端」なものは見つかる
- 23時の22,000円、22時の18,000円は
z_hourもz_amountも 2 未満で、見逃している
Z-score は1列ずつしか見ないので、「時刻だけ見ればふつう」「金額だけ見てもふつう」なデータは異常になりません。組み合わせの異常は苦手なんです。
IsolationForestで異常を見つける
では本題です。時刻と金額の2列をまとめて IsolationForest に渡します。結果は散布図でも確認しましょう。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest

plt.rcParams["font.family"] = "Meiryo"  # 日本語ラベル用(Windows)

df = pd.read_csv("card_log.csv")
X = df[["hour", "amount"]]

# contamination = 全体のうち「異常」とみなす割合の見込み(ここでは2%)
model = IsolationForest(n_estimators=200, contamination=0.02, random_state=0)
df["pred"] = model.fit_predict(X)          # 1 = ふつう, -1 = 異常
df["score"] = model.decision_function(X)   # マイナスで小さいほど異常っぽい

alerts = df[df["pred"] == -1].sort_values("score")
print(alerts[["hour", "amount", "label", "score"]].round(3))
print("異常判定:", len(alerts), "件 / 全", len(df), "件")

# 散布図で「どこが異常と判定されたか」を確認
ok = df[df["pred"] == 1]
plt.figure(figsize=(8, 5))
plt.scatter(ok["hour"], ok["amount"], s=20, alpha=0.6, label="ふつう")
plt.scatter(alerts["hour"], alerts["amount"], s=120, c="red", marker="x", label="異常と判定")
plt.xlabel("利用した時刻(時)")
plt.ylabel("金額(円)")
plt.title("カード利用履歴の異常検知(IsolationForest)")
plt.legend()
plt.grid(alpha=0.3)
plt.show()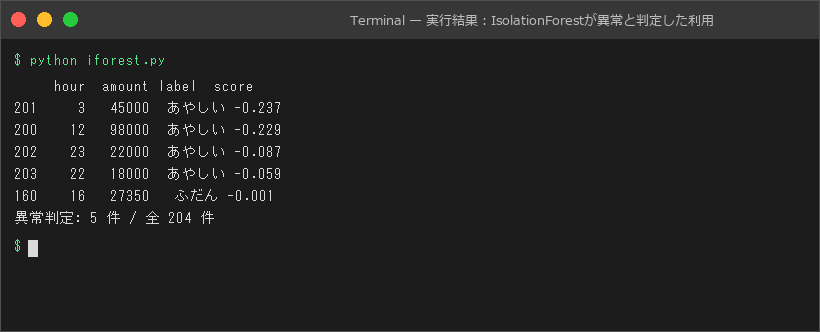
ポイントをまとめるとこんな感じです👇
fit_predict()は学習と判定を一度に行い、1(ふつう)か -1(異常)を返すdecision_function()はスコアを返す。マイナスで、小さいほど異常っぽいcontaminationは「全体の何割くらいが異常だと思うか」の見込み。この割合に合わせて判定の境目が決まるrandom_stateを固定すると、毎回同じ結果になる
実行すると、異常と判定された5件がスコアの低い順に表示されます(3時の45,000円が -0.237、12時の98,000円が -0.229、23時の22,000円が -0.087、22時の18,000円が -0.059、16時の27,350円が -0.001)。
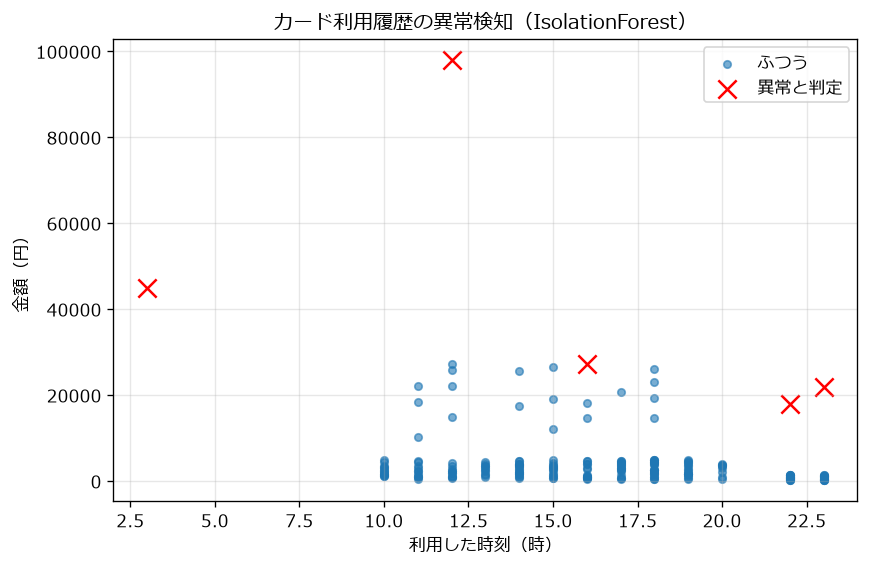
Z-score が見逃した23時の22,000円と22時の18,000円も、きちんと異常と判定されました🎉 スコアの順番を見ると、極端な2件(-0.237、-0.229)より値は大きいものの、ちゃんとマイナス側に入っています。
散布図を見ると、夜22〜23時のエリアには少額の点しかなく、そこにポツンと2万円前後の点があるのがわかりますね。この「群れから離れた場所」を2列まとめて見られるのが、IsolationForest の強みです。
⚠️「ふだん」の1件も引っかかった理由
結果をよく見ると、5件目に16時の27,350円(ふだんの利用)も入っています。これは失敗というより、contamination=0.02 の設定によるものです。
- 204件 × 2% ≒ 4件なので、境目はスコアの低いほうから4〜5件目あたりに置かれる
- 27,350円は大きめの買い物の中でも一番高い値で、スコアは -0.001。境目ギリギリでマイナス側に入った
実際に使うときは、こんなふうに考えるのがおすすめです。
- 判定結果をそのまま「不正」と決めつけない。「確認したほうがいい候補リスト」として使う
- スコアの低い順に並べて、上から確認する(今回なら -0.237 から順に見ていく)
- 見逃しを減らしたいなら
contaminationを大きめに、確認の手間を減らしたいなら小さめにする
どこまで拾うかは、「見逃したときの痛さ」と「確認の手間」のバランスで決めるのがコツです。
まとめ
- IsolationForest は「すぐ孤立するデータ=異常っぽい」と判定する方法で、正解ラベルがなくても使える
- Z-score は1列ずつ見るので、「値はふつうなのに組み合わせが変」な異常を見逃しやすい
- IsolationForest に複数の列をまとめて渡すと、夜遅くの高額利用のような組み合わせの異常も見つけられた
contaminationで判定の境目が変わるので、結果は「確認候補」として、スコアの低い順に見るのがおすすめ
今回はカードの明細でしたが、「アクセスログの時刻と回数」「センサーの温度と湿度」など、2つ以上の値の組み合わせで「いつもと違う」を探したい場面にそのまま使えます。手元のデータでも、ぜひ試してみてください😊
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR