scikit-learnで時系列予測入門!ラグ特徴量とTimeSeriesSplitで未来のカンニングを防ぐ
「scikit-learnで売上を予測してみたら、MAEがすごく小さくてうれしかったのに、本番ではまったく当たらない…」「日付つきのデータって、普通の機械学習と何が違うの?」――そんな悩み、ありますよね。
この記事では、カフェの1日ごとのコーヒー販売数を題材に、時系列データの予測を一から作ります。ポイントは「予測する時点で、まだ知らないはずの情報を使わない」こと。うっかり未来の値を使ってしまう「未来のカンニング」を、実際にコードを動かして確かめていきます。
難易度:scikit-learnで fit と predict を使ったことがある初〜中級者向け。使うのは pandas・scikit-learn・matplotlib だけです😊
時系列予測は「普通の機械学習」と何が違う?
時系列データとは、日付や時刻の順に並んだデータのことです。売上、気温、アクセス数などが代表例ですね。
普通の機械学習との一番の違いは、イメージとしては「答え合わせの順番が決まっている」ことです。
- 明日の販売数を予測するとき、使えるのは今日までのデータだけ
- なので、テストも「過去で学習 → その後の期間で答え合わせ」の順番でやる必要がある
- データをシャッフルしたり、未来の値が混ざった特徴量を作ったりすると、評価だけが良くなる
この「評価だけが良くなる」状態をデータリークと呼びます。この記事では、よくある3つの落とし穴を順番に踏んでみます⚠️
1年分の販売データを用意する
まずは練習用のデータを作ります。実際のお店のデータの代わりに、次の要素を足し合わせた「それっぽい」数字を乱数で作りました。
- 1年でゆるやかに増えていくトレンド
- 冬に多く夏に少ない季節の波
- 土日に多い曜日のクセ
- 日々のばらつき(ノイズ)
import numpy as np
import pandas as pd

# 1年分の「カフェのコーヒー販売数(杯)」を作る
rng = np.random.default_rng(42)
dates = pd.date_range("2025-01-01", "2025-12-31", freq="D")
n = len(dates)

trend = np.linspace(0, 20, n)                      # 1年でゆるやかに+20杯
season = 15 * np.cos(2 * np.pi * (dates.dayofyear - 15) / 365)  # 冬に多く、夏に少ない
weekday_effect = np.array([-10, -5, 0, 5, 15, 40, 30])[dates.dayofweek]  # 月〜日
noise = rng.normal(0, 8, n)

sales = (120 + trend + season + weekday_effect + noise).round().astype(int)
df = pd.DataFrame({"date": dates, "sales": sales})
df.to_csv("sales.csv", index=False)

print(df.head(7).to_string(index=False))
print("日数:", len(df))

# 曜日ごとの平均を見てみる
names = ["月", "火", "水", "木", "金", "土", "日"]
by_wd = df.groupby(df["date"].dt.dayofweek)["sales"].mean().round(1)
by_wd.index = names
print("\n曜日ごとの平均販売数")
print(by_wd.to_string())
実行すると sales.csv ができて、こう表示されました。
      date  sales
2025-01-01    137
2025-01-02    131
2025-01-03    156
2025-01-04    182
2025-01-05    149
2025-01-06    115
2025-01-07    131
日数: 365

曜日ごとの平均販売数
月    119.8
火    125.4
水    130.8
木    135.4
金    145.1
土    171.0
日    157.1
土曜日がいちばん多く、月曜日がいちばん少ないですね。乱数のシードを default_rng(42) で固定しているので、同じコードなら同じ数字になります。
「昨日までの情報」だけで特徴量を作る
時系列予測では、過去の値そのものを特徴量にするのが基本です。これをラグ特徴量と呼びます。pandasの shift() を使うと、列を下に1行ずつずらせます。
ここが重要です👇
shift(1):1行下にずらす=昨日の値が今日の行に来るshift(7):1週間前の同じ曜日の値shift(1).rolling(7).mean():先にずらしてから平均するので、昨日までの7日平均になる- 曜日(0〜6)は「6のほうが大きい」わけではないので、
get_dummiesで0/1の列に分ける
あとで何度も使うので、features.py という名前で保存しておきます。
import pandas as pd


def make_features(df):
    """昨日までの情報だけで特徴量を作る"""
    df = df.copy()
    df["lag1"] = df["sales"].shift(1)                      # 昨日の販売数
    df["lag7"] = df["sales"].shift(7)                      # 1週間前の販売数
    df["mean7"] = df["sales"].shift(1).rolling(7).mean()   # 昨日までの7日平均
    df["weekday"] = df["date"].dt.dayofweek                # 0=月 … 6=日
    # 曜日は「大小」ではなく「種類」なので0/1の列に分ける
    df = pd.get_dummies(df, columns=["weekday"], prefix="wd", dtype=int)
    return df.dropna()   # shiftで空いた最初の数日を捨てる


if __name__ == "__main__":
    df = pd.read_csv("sales.csv", parse_dates=["date"])
    feat = make_features(df)
    cols = ["date", "sales", "lag1", "lag7", "mean7", "wd_5"]
    print(feat[cols].head(4).round({"mean7": 1}).to_string(index=False))
    print("行数:", len(df), "→", len(feat))
date sales lag1 lag7 mean7 wd_5
2025-01-08 133 131.0 137.0 143.0 0
2025-01-09 140 133.0 131.0 142.4 0
2025-01-10 144 140.0 156.0 143.7 0
2025-01-11 183 144.0 182.0 142.0 1
行数: 365 → 3581月11日(土)の行を見てください。lag1 が前日1月10日の販売数144、lag7 が1週間前の1月4日(土)の182になっています。wd_5(土曜日)が1なのもわかりますね。
最初の7日間は「1週間前」が存在しないので空欄(NaN)になり、dropna() で捨てています。365行が358行に減ったのはそのためです。
落とし穴①:シャッフルして分けると、成績が良く見える
いよいよ学習です。最後の8週間(11月6日〜12月31日)を「まだ来ていない未来」とみなしてテストに使います。
比べるのは次の4つです。
- ベースライン:何も学習せず「昨日と同じ」「先週の同じ曜日と同じ」と答えるだけ
- 線形回帰とランダムフォレスト(時間順に分割)
- おまけに、
train_test_splitでシャッフルして分けたランダムフォレスト
ベースラインを先に測っておくのが大事なポイントです。モデルが「何もしない予測」に勝てていなければ、使う意味がないからです。
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error
from features import make_features

df = make_features(pd.read_csv("sales.csv", parse_dates=["date"]))
X_cols = ["lag1", "lag7", "mean7"] + [c for c in df.columns if c.startswith("wd_")]
X, y = df[X_cols], df["sales"]

# ⭕ 時間順に分ける:最後の8週間がテスト
X_train, X_test = X.iloc[:-56], X.iloc[-56:]
y_train, y_test = y.iloc[:-56], y.iloc[-56:]

models = {
    "線形回帰": LinearRegression(),
    "ランダムフォレスト": RandomForestRegressor(random_state=0),
}
# まずは何も学習しない予測(ベースライン)
print("【ベースライン】")
print(f"  昨日と同じ: MAE = {mean_absolute_error(y_test, X_test['lag1']):.1f} 杯")
print(f"  先週の同じ曜日と同じ: MAE = {mean_absolute_error(y_test, X_test['lag7']):.1f} 杯")

print("【時間順に分割】")
for name, model in models.items():
    model.fit(X_train, y_train)
    mae = mean_absolute_error(y_test, model.predict(X_test))
    print(f"  {name}: MAE = {mae:.1f} 杯")

# ❌ シャッフルして分ける(未来の日が学習側に混ざる)
Xa, Xb, ya, yb = train_test_split(X, y, test_size=56, random_state=0)
rf = RandomForestRegressor(random_state=0).fit(Xa, ya)
print("【シャッフルして分割】")
print(f"  ランダムフォレスト: MAE = {mean_absolute_error(yb, rf.predict(Xb)):.1f} 杯")

# ランダムフォレストが学習で見た販売数の範囲と、テスト期間の実際の値
print("学習データの最大値:", y_train.max(), "杯 / テスト期間の最大値:", y_test.max(), "杯")
print("ランダムフォレストの予測の最大値:", round(models["ランダムフォレスト"].predict(X_test).max(), 1), "杯")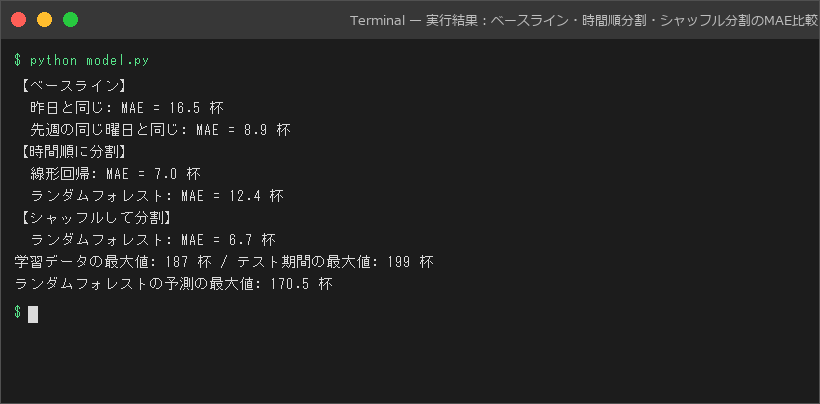
【ベースライン】
  昨日と同じ: MAE = 16.5 杯
  先週の同じ曜日と同じ: MAE = 8.9 杯
【時間順に分割】
  線形回帰: MAE = 7.0 杯
  ランダムフォレスト: MAE = 12.4 杯
【シャッフルして分割】
  ランダムフォレスト: MAE = 6.7 杯
学習データの最大値: 187 杯 / テスト期間の最大値: 199 杯
ランダムフォレストの予測の最大値: 170.5 杯
結果を整理するとこうなります。
| 方法 | MAE(平均の外れ幅) |
|---|---|
| 昨日と同じ | 16.5杯 |
| 先週の同じ曜日と同じ | 8.9杯 |
| 線形回帰(時間順) | 7.0杯 |
| ランダムフォレスト(時間順) | 12.4杯 |
| ランダムフォレスト(シャッフル) | 6.7杯 ⚠️ |
注目してほしいのは、同じランダムフォレストなのにシャッフルすると12.4杯→6.7杯と、まるで別物のように良く見えることです。
シャッフルすると、11〜12月の日の多くが学習側に入ります。つまり「年末はこのくらい売れる」という未来の答えを見てからテストを受けている状態です。本番で予測するときには未来のデータはないので、この6.7杯は当てになりません。
なぜランダムフォレストは線形回帰に負けたの?
「ランダムフォレストのほうが強いモデルなのでは?」と思いますよね。ここが時系列ならではのつまずきです。
- このデータは1年かけて増えていて、テスト期間(11〜12月)は1年でいちばん販売数が多い時期
- 学習データの最大値は187杯なのに、テスト期間には199杯の日がある
- ランダムフォレストの予測は、学習データの値を平均したものなので、学習データの範囲を超えた値を出せない(今回の予測の最大値は170.5杯)
一方、線形回帰は「先週が多ければ今週も多い」という関係を直線で表すので、過去にない大きな値でもそのまま伸ばして予測できます。右肩上がりのデータでは、決定木系のモデルは苦手と覚えておくとよいです。
落とし穴②:特徴量に「明日」が混ざっている
2つ目の落とし穴は、特徴量を作る段階で未来が混ざるパターンです。よくあるのが、移動平均を center=True(前後の日を含めた平均)で作ってしまうケースです。
これ、実行せずに答えられますか? 「前後1日を含む3日平均」と「昨日までの7日平均」、どちらのMAEが小さくなるでしょう?
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error
from features import make_features

df = make_features(pd.read_csv("sales.csv", parse_dates=["date"]))
wd_cols = [c for c in df.columns if c.startswith("wd_")]

# ❌ 前後1日を含む3日平均(center=True)=「明日」の値が混ざる
df["mean3_center"] = df["sales"].rolling(3, center=True).mean()
df = df.dropna()
train, test = df.iloc[:-56], df.iloc[-56:]

for extra in ["mean7", "mean3_center"]:
    cols = wd_cols + [extra]
    model = LinearRegression().fit(train[cols], train["sales"])
    mae = mean_absolute_error(test["sales"], model.predict(test[cols]))
    print(f"曜日 + {extra}: MAE = {mae:.1f} 杯")

# テスト期間の最後の日はいつになった?
print("テスト期間の最終日:", test["date"].iloc[-1].date())
曜日 + mean7: MAE = 7.2 杯
曜日 + mean3_center: MAE = 5.4 杯
テスト期間の最終日: 2025-12-303日平均のほうが 7.2杯→5.4杯 と大きく改善しました。でもこれはカンニングです⚠️
rolling(3, center=True)は「昨日・今日・明日」の平均。つまり当てたい今日の値そのものと明日の値が入っている- その証拠に、テスト期間の最終日が12月30日に変わっています。12月31日は「明日(1月1日)」のデータがないので、平均が作れず
dropna()で消えたのです
「最後の行が消えた」「予測したい日の特徴量が作れない」というのは、未来の値を使っているサインです。特徴量を作ったら、予測したい日の前日の時点で、その値がわかるか? を1つずつ確かめるクセをつけましょう。
落とし穴③:テスト期間が1回だけだと、たまたまの結果かも
ここまでは「最後の8週間」の1回だけで評価してきました。でも、その8週間がたまたま当てやすい時期だった可能性もありますよね。
そこで使うのが TimeSeriesSplit です。イメージとしては、カレンダーを少しずつ進めながら、何回も「過去で学習 → 直後でテスト」をくり返す交差検証です。普通の KFold と違って、テストは必ず学習期間より後になります。
ポイントをまとめるとこんな感じです👇
n_splits=5:5回くり返すtest_size=28:テストは毎回4週間(28日)cross_val_scoreのcvにそのまま渡せるscoring="neg_mean_absolute_error"はマイナス付きで返るので、-を付けて戻す
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import TimeSeriesSplit, cross_val_score
from features import make_features

df = make_features(pd.read_csv("sales.csv", parse_dates=["date"]))
X_cols = ["lag1", "lag7", "mean7"] + [c for c in df.columns if c.startswith("wd_")]
X, y = df[X_cols], df["sales"]

# 4週間ずつ5回、「過去で学習 → 直後の4週間でテスト」をくり返す
tscv = TimeSeriesSplit(n_splits=5, test_size=28)
for i, (tr, te) in enumerate(tscv.split(X), start=1):
    d = df["date"]
    print(f"{i}回目: 学習 {d.iloc[tr[0]].date()}〜{d.iloc[tr[-1]].date()}"
          f" / テスト {d.iloc[te[0]].date()}〜{d.iloc[te[-1]].date()}")

for name, model in [("線形回帰", LinearRegression()),
                    ("ランダムフォレスト", RandomForestRegressor(random_state=0))]:
    scores = -cross_val_score(model, X, y, cv=tscv, scoring="neg_mean_absolute_error")
    print(f"{name}: 各回のMAE {scores.round(1)} 平均 {scores.mean():.1f} 杯")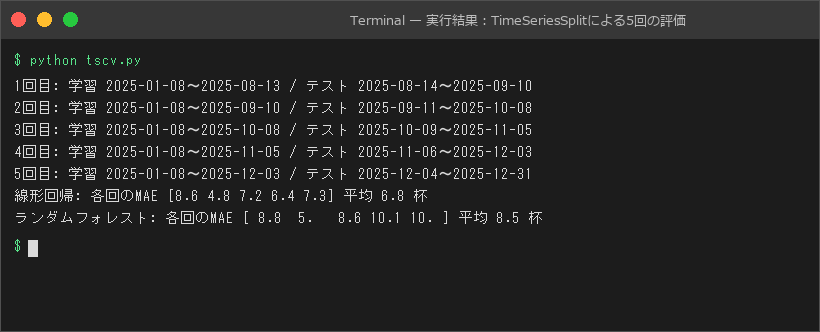
1回目: 学習 2025-01-08〜2025-08-13 / テスト 2025-08-14〜2025-09-10
2回目: 学習 2025-01-08〜2025-09-10 / テスト 2025-09-11〜2025-10-08
3回目: 学習 2025-01-08〜2025-10-08 / テスト 2025-10-09〜2025-11-05
4回目: 学習 2025-01-08〜2025-11-05 / テスト 2025-11-06〜2025-12-03
5回目: 学習 2025-01-08〜2025-12-03 / テスト 2025-12-04〜2025-12-31
線形回帰: 各回のMAE [8.6 4.8 7.2 6.4 7.3] 平均 6.8 杯
ランダムフォレスト: 各回のMAE [ 8.8  5.   8.6 10.1 10. ] 平均 8.5 杯
学習期間がだんだん伸びて、テストはいつもその直後の4週間になっているのがわかります。
- 線形回帰は5回の平均が6.8杯。1回目は8.6杯、2回目は4.8杯と、時期によってけっこう差がある
- ランダムフォレストは平均8.5杯で、販売数が伸びる4・5回目(11〜12月)で10杯前後まで悪化
1回のテストだけだと「4.8杯!」のような当たりの回を引いてしまうこともあります。何回かの平均とばらつきを見ると、モデルの実力がわかりやすくなります。
予測をグラフで確かめて、明日の販売数を出す
最後に、線形回帰の予測を実際の値と並べてグラフにし、全データで学習し直して2026年1月1日の販売数を予測します。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from features import make_features

plt.rcParams["font.family"] = "Meiryo"   # Macは "Hiragino Sans" など

raw = pd.read_csv("sales.csv", parse_dates=["date"])
df = make_features(raw)
X_cols = ["lag1", "lag7", "mean7"] + [c for c in df.columns if c.startswith("wd_")]
train, test = df.iloc[:-56], df.iloc[-56:]

model = LinearRegression().fit(train[X_cols], train["sales"])
test = test.assign(pred=model.predict(test[X_cols]))

plt.figure(figsize=(10, 4))
plt.plot(test["date"], test["sales"], marker="o", ms=3, label="実際の販売数")
plt.plot(test["date"], test["pred"], linestyle="--", label="線形回帰の予測")
plt.plot(test["date"], test["lag7"], alpha=0.5, label="先週の同じ曜日")
plt.title("最後の8週間:実際の販売数と予測")
plt.ylabel("販売数(杯)")
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.show()

# 全データで学習し直して「明日(2026-01-01)」を予測する
model.fit(df[X_cols], df["sales"])
s = raw["sales"]
next_day = pd.Timestamp("2026-01-01")
row = {"lag1": s.iloc[-1], "lag7": s.iloc[-7], "mean7": s.iloc[-7:].mean()}
for i in range(7):
    row[f"wd_{i}"] = int(next_day.dayofweek == i)
pred = model.predict(pd.DataFrame([row])[X_cols])[0]
print(next_day.date(), "の曜日番号:", next_day.dayofweek, "→ 予測", round(pred), "杯")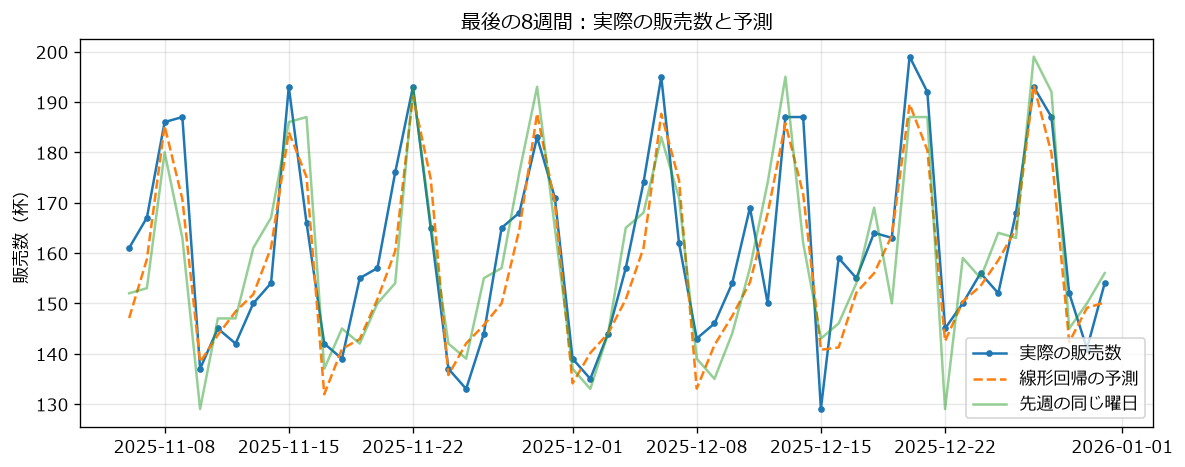
2026-01-01 の曜日番号: 3 → 予測 158 杯グラフを見ると、予測(点線)は土日の山と平日の谷をきちんと追えています。「先週の同じ曜日」(薄い線)よりも、実際の値に近い日が多いですね。
明日の予測では、特徴量を手で組み立てているところがポイントです。
lag1:最後の日(12月31日)の値lag7:1週間前(12月25日)の値mean7:最後の7日間の平均- 曜日:1月1日は木曜日(曜日番号3)なので
wd_3だけ1
どれも12月31日の時点でわかる値だけです。本番で作れる特徴量だけでモデルを作る――これが時系列予測でいちばん大切な考え方です。
なお、Macでは Meiryo フォントがないので、"Hiragino Sans" などに変えてください。
まとめ
- 時系列予測では、予測する時点でわかっている情報だけを使う
- ラグ特徴量は
shift()、移動平均はshift(1).rolling(7).mean()のように先にずらしてから計算する - テストは時間順に分ける。シャッフルすると今回は12.4杯→6.7杯と、実力以上に良く見えた
center=Trueの移動平均は「明日」が混ざる。最後の行が消えたら要注意- まずは「先週の同じ曜日と同じ」などのベースラインを測り、それに勝てるかを見る
- 右肩上がりのデータでは、ランダムフォレストは学習データの範囲を超えた値を出せない
TimeSeriesSplitで何回か評価して、平均とばらつきを見る
「評価が良すぎるときほど疑う」という感覚がつかめると、機械学習の結果を自信を持って説明できるようになります。お手元の売上データやアクセス数でも、ぜひ試してみてください🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR