scikit-learnの回帰モデルの評価入門!家賃予測でMAE・R²を測り、残差グラフで外れる理由を見つける
「scikit-learnで予測モデルを作ってみたけど、この予測って当たってるの?」
「R²が0.97って出たけど、それが良いのか悪いのか、正直よくわからない…」
機械学習を始めたばかりだと、こんなモヤモヤありますよね。分類(迷惑メールかどうか、など)の評価は「正解率」で直感的にわかりますが、家賃や売上のような「数値」を当てる回帰は、どれくらい外れたら失敗なのかがイメージしにくいところです。
この記事では、家賃のデータを使って scikit-learn の線形回帰で予測モデルを作り、
- MAE・RMSE・R² で「どれくらい当たっているか」を数字で測る
- 「平均で答えるだけのモデル」と比べて、本当に役に立っているか確かめる
- 残差(実際−予測)をグラフにして、モデルの「クセ」を見つけて改善する
ところまで、実際にコードを動かしながら進めます。
- 対象:Pythonの基本と pandas の読み込みくらいがわかる初〜中級者
- 使うもの:Python 3、pandas、scikit-learn、matplotlib
- 所要時間:30分ほど
「むずかしそう」を「できそう」に変えるつもりで、一緒に見ていきましょう!🚀
準備:ライブラリを入れる
まだ入っていない方は、次のコマンドでインストールしてください(この記事は scikit-learn 1.9.0・pandas 3.0.3 で動作を確認しています)。
pip install pandas scikit-learn matplotlibステップ1:練習用の家賃データを作る
本物の物件データは手に入れにくいので、今回はPythonで練習用のデータを作ります。「広さ」「駅徒歩」「築年数」から家賃が決まる、架空の物件300件です。
ここが重要です👇
- 家賃は「広さ1㎡で+2,000円、駅徒歩1分で−1,000円、築1年で−500円」という本当のルールで作っています
- さらに「徒歩15分を超えると1分ごとに追加で−1,500円」という、ちょっとひねったルールをこっそり入れています(バス便エリアのイメージです)
- モデルはこのルールを知りません。データだけからどこまで見抜けるかが今回のテーマです
答えを知っているデータで練習すると、「モデルが正しく学べたか」を答え合わせできるのがメリットです😊
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)  # 乱数の種を固定(毎回同じデータになる)
n = 300

area = rng.uniform(18, 60, n).round(1)   # 広さ(㎡)
walk = rng.integers(1, 26, n)            # 駅徒歩(分)
age = rng.integers(0, 41, n)             # 築年数(年)

# 「本当の家賃のルール」(モデルはこれを知らない)
rent = 55000 + 2000 * area - 1000 * walk - 500 * age
rent = rent - np.where(walk > 15, (walk - 15) * 1500, 0)  # 徒歩15分を超えると急に安くなる
rent = rent + rng.normal(0, 3000, n)                       # 物件ごとのばらつき

df = pd.DataFrame({
    "広さ": area,
    "駅徒歩": walk,
    "築年数": age,
    "家賃": ((rent / 100).round() * 100).astype(int),  # 100円単位に丸める
})
df.to_csv("rent.csv", index=False, encoding="utf-8-sig")

print(df.head())
print(f"件数: {len(df)}件 / 家賃の平均: {df['家賃'].mean():,.0f}円")
実行すると rent.csv ができて、先頭5件が表示されます。
     広さ  駅徒歩  築年数      家賃
0  50.5   16    0  142200
1  36.4   20    1   99000
2  54.1   19    8  135300
3  47.3    4   36  120400
4  22.0   21   18   56500
件数: 300件 / 家賃の平均: 104,648円
ステップ2:線形回帰で学習する
線形回帰は、イメージとしては「家賃 = 基本料金 + 広さ×いくら + 駅徒歩×いくら + 築年数×いくら」という式の「いくら」の部分を、データにいちばん当てはまるように決める方法です。
ポイントをまとめるとこんな感じです👇
train_test_splitで、8割を学習用、2割をテスト用に分ける。テスト用は学習に使わず、最後の「本番テスト」に取っておきますfit()で学習すると、intercept_(切片=基本料金)とcoef_(係数=各列の「いくら」)が決まる
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

df = pd.read_csv("rent.csv", encoding="utf-8-sig")
X = df[["広さ", "駅徒歩", "築年数"]]  # 入力(特徴量)
y = df["家賃"]                       # 当てたい答え(目的変数)

# 8割で学習、2割はテスト用に取っておく
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=0
)

model = LinearRegression()
model.fit(X_train, y_train)

print(f"切片: {model.intercept_:,.0f}円")
for name, coef in zip(X.columns, model.coef_):
    print(f"{name}が1増えると: {coef:+,.0f}円")
切片: 57,223円
広さが1増えると: +2,035円
駅徒歩が1増えると: -1,548円
築年数が1増えると: -506円広さ(+2,035円)と築年数(−506円)は、本当のルール(+2,000円・−500円)にかなり近い値になりました。
ところが駅徒歩は −1,548円。本当は −1,000円なのに、だいぶ大きめです。なぜでしょう? 実は、ここに後で見つける「クセ」のヒントが隠れています。先に評価のしかたを見ていきましょう。
ステップ3:MAE・RMSE・R²で「当たり具合」を測る
回帰の評価でよく使う指標は、この3つです。
| 指標 | ざっくり言うと | 見方 |
|---|---|---|
| MAE(平均絶対誤差) | 予測が平均で何円ずれたか | 小さいほど良い。単位が「円」なので一番わかりやすい |
| RMSE(二乗平均平方根誤差) | ずれを2乗して平均し、ルートで戻したもの | 小さいほど良い。大外れがあると大きくなる |
| R²(決定係数) | 「平均で答える」よりどれだけマシか | 1に近いほど良い。0なら平均と同じ、マイナスなら平均以下 |
つまり、MAEで「何円ずれるか」をつかみ、RMSEとの差で「大外れが混ざっていないか」を見て、R²で「そもそも役に立っているか」を確かめる、という使い分けです。
比べる相手として、DummyRegressor で「いつも学習データの平均家賃を答えるだけ」のモデルも用意します。これに勝てないモデルは、どれだけ数字がそれっぽくても意味がありません⚠️
import numpy as np
import pandas as pd
from sklearn.dummy import DummyRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
from sklearn.model_selection import train_test_split

df = pd.read_csv("rent.csv", encoding="utf-8-sig")
X = df[["広さ", "駅徒歩", "築年数"]]
y = df["家賃"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=0
)

def report(name, model):
    model.fit(X_train, y_train)
    pred = model.predict(X_test)  # テストデータ(学習に使っていない物件)で予測
    mae = mean_absolute_error(y_test, pred)
    rmse = np.sqrt(mean_squared_error(y_test, pred))
    r2 = r2_score(y_test, pred)
    print(f"【{name}】 MAE: {mae:,.0f}円 / RMSE: {rmse:,.0f}円 / R²: {r2:.3f}")

# 比較用:いつも「学習データの平均家賃」と答えるだけのモデル
report("平均で答える", DummyRegressor(strategy="mean"))
report("線形回帰", LinearRegression())平均で答えるだけだと、平均で約2.5万円もずれます(R²はほぼ0)。線形回帰はMAEが約3,500円、R²は0.978。家賃10万円前後の物件で3,500円程度のずれなので、かなり当たっていると言えそうです。
⚠️ R²は「データのばらつき方」によっても値が変わるので、R²だけで「0.9以上なら合格」のように決めつけないのがコツです。MAEを実際の単位(円)で見て、使う場面で許せるずれかどうかを考えましょう。
ステップ4:残差をグラフにして「クセ」を見つける
平均のずれが小さくても、「特定の条件の物件だけ、いつも同じ方向に外れる」ということがあります。それを見つけるのが残差(実際の家賃−予測した家賃)です。プラスなら「予測より実際が高い」、マイナスなら「予測より実際が安い」物件です。
- 左のグラフ:実際と予測の散布図。点線に乗っているほど予測ぴったり
- 右のグラフ:横軸を駅徒歩にして残差を並べる。ランダムに散らばっていれば問題なし、形があったらクセあり
import matplotlib.pyplot as plt
from matplotlib.ticker import FuncFormatter
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

plt.rcParams["font.family"] = "Meiryo"  # 日本語ラベル用(Macなら "Hiragino Sans")

df = pd.read_csv("rent.csv", encoding="utf-8-sig")
X = df[["広さ", "駅徒歩", "築年数"]]
y = df["家賃"]
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=0
)
model = LinearRegression().fit(X_train, y_train)

result = X_test.copy()
result["実際"] = y_test
result["予測"] = model.predict(X_test).round(-2)
result["残差"] = result["実際"] - result["予測"]  # プラス=予測より高い物件

# 外れ方が大きい物件トップ5
worst = result.reindex(result["残差"].abs().sort_values(ascending=False).index)
print(worst.head(5).to_string())

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.5))
ax1.scatter(result["実際"], result["予測"], alpha=0.7)
lims = [result["実際"].min(), result["実際"].max()]
ax1.plot(lims, lims, color="gray", linestyle="--")  # この線に乗れば予測ぴったり
ax1.set_xlabel("実際の家賃")
ax1.set_ylabel("予測した家賃")
ax1.set_title("実際 vs 予測")

ax2.scatter(result["駅徒歩"], result["残差"], alpha=0.7, color="tab:orange")
ax2.axhline(0, color="gray", linestyle="--")
ax2.set_xlabel("駅徒歩(分)")
ax2.set_ylabel("残差=実際−予測")
ax2.set_title("駅徒歩ごとの残差")

# 目盛りを「12万」のような表記にして読みやすく
man = FuncFormatter(lambda v, _: f"{v / 10000:.0f}万")
ax1.xaxis.set_major_formatter(man)
ax1.yaxis.set_major_formatter(man)
ax2.yaxis.set_major_formatter(FuncFormatter(lambda v, _: f"{v / 10000:+.1f}万"))

plt.tight_layout()
plt.show()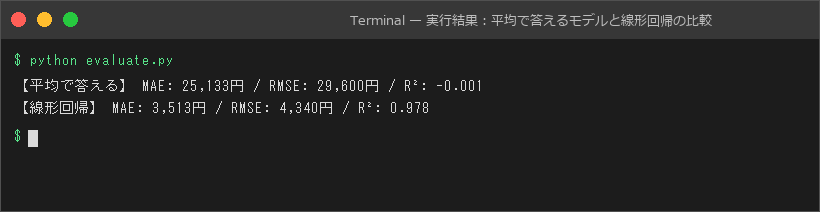
外れ方が大きい物件トップ5はこうなりました。
       広さ  駅徒歩  築年数      実際        予測       残差
92   36.7   24    8   79200   90700.0 -11500.0
15   27.5   16   18   89000   79300.0   9700.0
176  36.3   11   29  108200   99400.0   8800.0
52   51.1    6   25  131500  139300.0  -7800.0
206  23.5   14   10   85700   78300.0   7400.0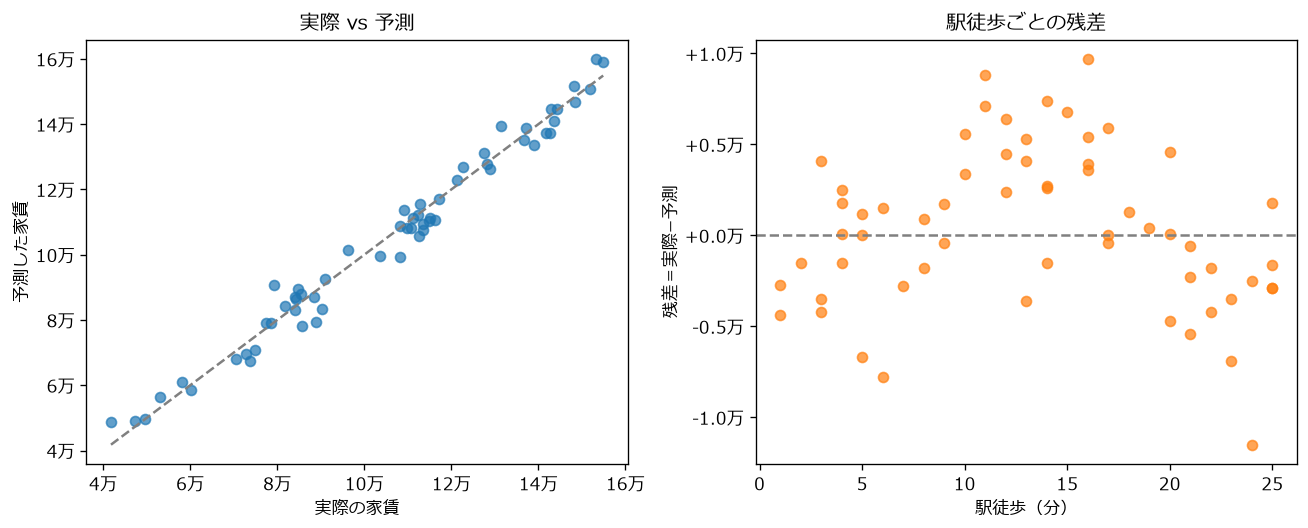
右のグラフを見ると、残差が0のまわりにランダムに散らばっているのではなく、徒歩10〜16分あたりはプラス、徒歩20分以上はマイナスに寄った「山なり」の形になっています。一番外れた物件も徒歩24分(予測より1.15万円安い)でした。
これは、「徒歩15分を超えると急に安くなる」ルールを、線形回帰がまっすぐな線1本で無理やり表そうとした結果です。遠い物件の安さに引っぱられて駅徒歩の係数が −1,548円と大きめになり、そのぶん中間の物件を安く見積もりすぎていたんですね。ステップ2の「なぜ?」の答えはこれでした。
ステップ5:列を1つ足して改善する
クセの正体がわかったので、「徒歩15分を何分こえているか」という列を追加してみます(15分以内は0)。こうすると線形回帰でも「15分を超えたら下がり方が変わる」を表せるようになります。
ついでに、こういう折れ曲がりを自動で学べるランダムフォレスト(3列のまま)とも比べてみましょう。
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import train_test_split

df = pd.read_csv("rent.csv", encoding="utf-8-sig")
# 残差グラフを見て追加する列:「徒歩15分を何分こえているか」(15分以内は0)
df["徒歩15分超"] = (df["駅徒歩"] - 15).clip(lower=0)

y = df["家賃"]
train_idx, test_idx = train_test_split(df.index, test_size=0.2, random_state=0)

def report(name, model, cols):
    X = df[cols]
    model.fit(X.loc[train_idx], y.loc[train_idx])
    pred = model.predict(X.loc[test_idx])
    mae = mean_absolute_error(y.loc[test_idx], pred)
    r2 = r2_score(y.loc[test_idx], pred)
    print(f"【{name}】 MAE: {mae:,.0f}円 / R²: {r2:.3f}")
    return model

base = ["広さ", "駅徒歩", "築年数"]
report("線形回帰(3列)", LinearRegression(), base)
lin = report("線形回帰(4列)", LinearRegression(), base + ["徒歩15分超"])
report("ランダムフォレスト(3列)",
       RandomForestRegressor(n_estimators=300, random_state=0), base)

print("--- 4列モデルの係数 ---")
for name, coef in zip(base + ["徒歩15分超"], lin.coef_):
    print(f"{name}: {coef:+,.0f}円")

# 新しい物件の家賃を予測してみる
new = pd.DataFrame({"広さ": [30.0, 30.0], "駅徒歩": [10, 20], "築年数": [15, 15]})
new["徒歩15分超"] = (new["駅徒歩"] - 15).clip(lower=0)
for (_, row), p in zip(new.iterrows(), lin.predict(new)):
    print(f"{row['広さ']}㎡・徒歩{row['駅徒歩']:.0f}分・築{row['築年数']:.0f}年 → 約{p:,.0f}円")
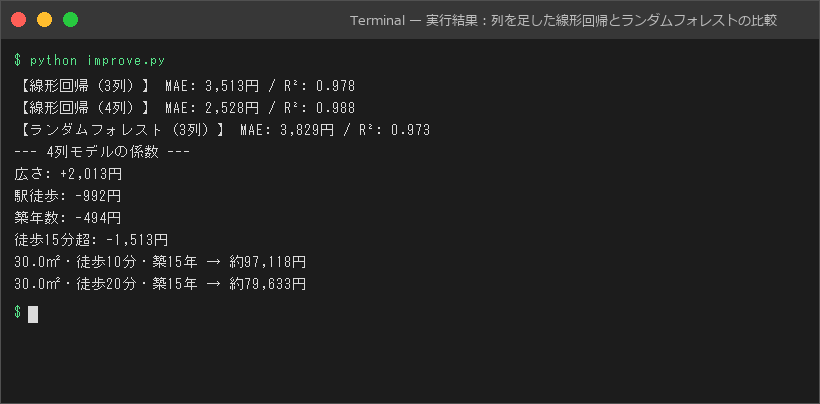
結果を見てみましょう。これ、実行する前に予想できますか? 「複雑なランダムフォレストが一番強いはず」と思った方も多いのではないでしょうか。
実際は、列を1つ足しただけの線形回帰が MAE 2,528円・R² 0.988 で一番でした。ランダムフォレストは MAE 3,829円で、元の線形回帰(3,513円)にも届きませんでした。学習データが240件と少ないうえ、元のルールがほぼ「足し算」でできているので、線形回帰のほうが向いていたわけです。
さらに4列モデルの係数を見ると、広さ +2,013円・駅徒歩 −992円・築年数 −494円・徒歩15分超 −1,513円。データを作ったときの本当のルールをほぼそのまま見抜けています👏
新しい物件の予測でも、同じ30㎡・築15年で徒歩10分なら約9.7万円、徒歩20分なら約8.0万円と、15分を超えた分の下がり方がきちんと反映されています。
ここが重要です👇
- モデルを複雑にする前に、残差を見てクセを探す
- クセの原因がわかれば、列(特徴量)を工夫するだけで大きく改善することがある
- モデルを比べるときは、同じテストデータ・同じ指標で比べる(今回は
random_state=0で分け方を固定)
実際のデータで使うときの注意
- 今回は答えを知っている練習用データなので、きれいな結果になっています。実データでは、立地・設備・階数など、表に無い理由で外れることも多いです。残差が大きい物件を1件ずつ見ると、「角部屋だった」「リフォーム済みだった」のような、足すべき列のヒントが見つかります
- テストデータの結果を見ながら何度も調整すると、テストデータに合わせすぎてしまいます。調整が多くなってきたら、
cross_val_scoreでの交差検証も使いましょう - 学習データにない範囲(今回なら100㎡の物件や徒歩40分の物件)の予測は、当てにならないと考えておくのが安全です
各指標の詳しい定義は、scikit-learn 公式ドキュメントの「Regression metrics」にまとまっています。
まとめ
- 回帰の評価は、MAE(何円ずれるか)・RMSE(大外れの有無)・R²(平均より役立つか)をセットで見る
DummyRegressorの「平均で答えるモデル」と比べると、本当に意味があるかがわかる- 残差をグラフにして形があれば、モデルが見落としているクセがある
- クセに合わせて列を1つ足すだけで、MAEが3,513円→2,528円に改善した。複雑なモデルが勝つとは限らない
「R²が高いからOK」で終わらせずに、残差まで見る習慣をつけると、モデルの理解がぐっと深まります。手元のデータでも、ぜひ試してみてください😊
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR