scikit-learnの特徴量重要度入門!permutation_importanceで本当に効いている列を見抜く
「ランダムフォレストで予測はできた。でも、どの列が効いているのかを説明してと言われると困る…」「feature_importances_ の数字をそのまま信じていいの?」
モデルを作ったあとに必ず出てくる疑問ですよね。この記事では、scikit-learnで特徴量重要度を出す2つの方法、feature_importances_(不純度ベース)と permutation_importance を同じデータで比べます。
対象は、scikit-learnで fit と score を使ったことがある初〜中級者です。動作確認は Python 3.13・scikit-learn 1.9.0 で行っています。一緒に見ていきましょう! 😊
特徴量重要度とは?「どの材料が味を決めているか」
イメージとしては、カレーの味見をしながら「この味はスパイスが決め手なのか、玉ねぎなのか」を探る作業です。モデルが予測に使った列(特徴量)のうち、どれが結果を大きく左右しているかを数値にしたものが特徴量重要度です。
今回は練習用に、アイスの1日の販売数のデータを作ります。答え合わせができるように、本当の関係はこちらで決めておきます。
- 気温:いちばん効く(1℃上がると4個増える)
- 休日:休日は25個増える
- 降水量:1mmにつき3個減る
- 伝票番号:0〜9999のでたらめな数。販売数とまったく関係ない列をわざと混ぜます
サンプル1:feature_importances_ を出してみる
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split

# --- 練習用データ:アイスの1日の販売数(3年分)を作る ---
rng = np.random.default_rng(0)
n = 1095
df = pd.DataFrame({
    "気温": rng.uniform(0, 35, n).round(1),      # ℃
    "降水量": rng.exponential(3, n).round(1),    # mm
    "休日": rng.integers(0, 2, n),               # 0=平日, 1=休日
    "伝票番号": rng.integers(0, 10000, n),       # 売上と無関係な列(わざと入れる)
})
# 本当の関係:気温がいちばん効き、次に休日、雨は少しマイナス
df["販売数"] = (4 * df["気温"] + 25 * df["休日"] - 3 * df["降水量"]
               + rng.normal(0, 15, n) + 40).round()

X = df.drop(columns="販売数")
y = df["販売数"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)

model = RandomForestRegressor(n_estimators=200, random_state=0)
model.fit(X_train, y_train)
print(f"テストデータの決定係数: {model.score(X_test, y_test):.3f}")

# --- 特徴量重要度(不純度ベース)を大きい順に表示 ---
imp = pd.Series(model.feature_importances_, index=X.columns).sort_values(ascending=False)
print("\n[feature_importances_]")
for name, v in imp.items():
    print(f"{name: <5} {v:.3f} " + "■" * int(v * 50))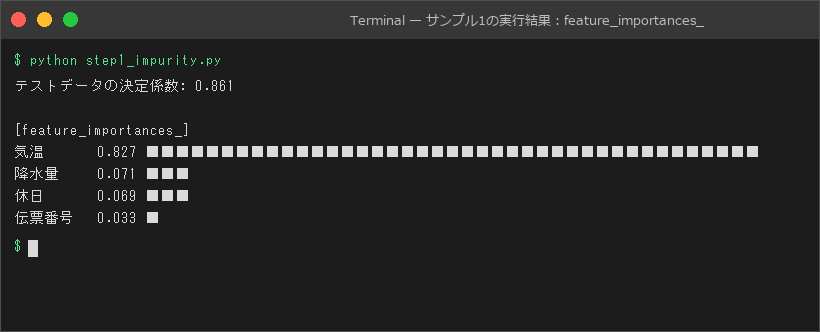
実行結果はこうなりました。
テストデータの決定係数: 0.861

[feature_importances_]
気温    0.827 ■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■■
降水量   0.071 ■■■
休日    0.069 ■■■
伝票番号  0.033 ■
ポイントをまとめるとこんな感じです👇
- 気温が0.827でダントツ。ここは本当の関係どおり
- ところが降水量(0.071)が休日(0.069)を上回っています。本当は休日の影響(25個)のほうが、雨の影響(平均3mm程度×3個)より大きいはずです
- 関係ないはずの伝票番号にも0.033の重要度が付いています
なぜこうなるのでしょうか。feature_importances_ は「木を分岐させるときに、その列でどれだけ誤差が減ったか」を学習データ上で合計した値です。値の種類が多い列(伝票番号や降水量)は区切り方の候補がたくさんあるので、たまたま学習データにうまく当てはまる分岐が見つかりやすいんです。0と1しかない休日は、そのぶん不利になります。scikit-learnの公式ドキュメントでも、不純度ベースの重要度は値の種類が多い特徴量を過大評価しやすいと注意されています。
サンプル2:permutation_importance で測り直す
もう1つの方法が permutation importance(並べ替え重要度)です。つまり、テストデータのある1列だけをシャッフルして、精度がどれだけ落ちるかを測ります。本当に使っている列を壊せば精度はガクッと落ち、使っていない列なら何も変わらない、という考え方です。
# ↓ サンプル1の続きに書き足して実行します
import matplotlib.pyplot as plt
from sklearn.inspection import permutation_importance

# --- テストデータで「列をシャッフルしたら精度がどれだけ落ちるか」を測る ---
result = permutation_importance(model, X_test, y_test, n_repeats=10, random_state=0)
perm = pd.DataFrame({
    "平均": result.importances_mean,
    "ばらつき": result.importances_std,
}, index=X.columns).sort_values("平均", ascending=False)
print("\n[permutation_importance](決定係数の下がり幅)")
print(perm.round(3))

# --- 2つの重要度を横に並べてグラフにする ---
plt.rcParams["font.family"] = "Meiryo"  # Windowsの日本語フォント
order = perm.index[::-1]
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].barh(order, imp[order], color="#9aa5b1")
axes[0].set_title("feature_importances_(学習データ)")
axes[1].barh(order, perm.loc[order, "平均"], xerr=perm.loc[order, "ばらつき"], color="#3f51b5")
axes[1].set_title("permutation_importance(テストデータ)")
plt.tight_layout()
plt.show()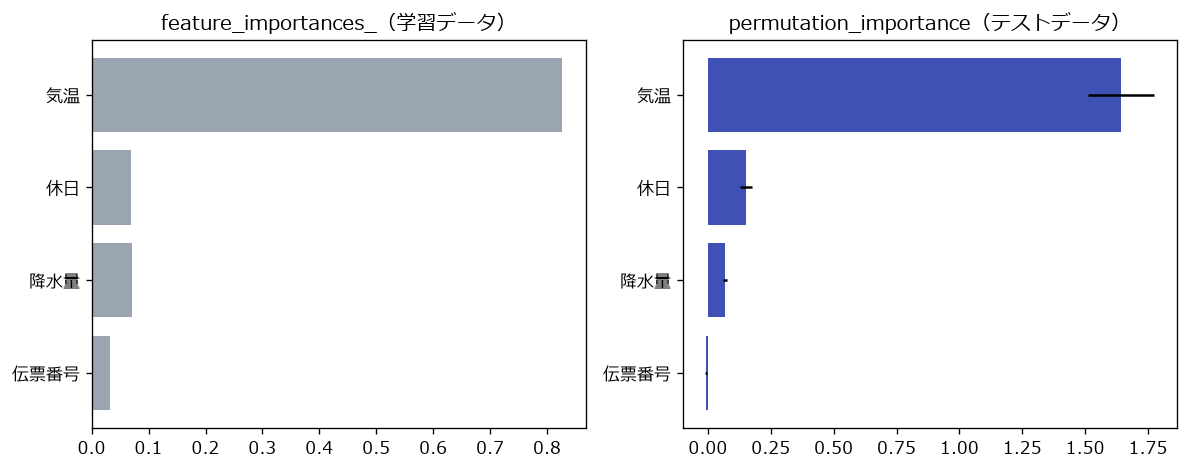
実行結果はこちら(サンプル1の出力に続いて表示されます)。
[permutation_importance](決定係数の下がり幅)
         平均   ばらつき
気温    1.644  0.131
休日    0.151  0.023
降水量   0.067  0.009
伝票番号 -0.008  0.003
ここが重要です👇
- 順位が気温 → 休日 → 降水量になり、最初に決めた本当の関係どおりに並びました
- 伝票番号は -0.008。シャッフルしても精度がまったく落ちない=予測の役に立っていないことがはっきりわかります(マイナスは偶然のぶれです)
- 「ばらつき」は10回シャッフルしたときの標準偏差。平均がばらつきと同じくらい小さい列は「効いていない」と見てOKです
グラフで並べると、違いがひと目でわかります。
サンプル3:本当に要らない列か、外して確かめる
「伝票番号は要らない」という見立てが正しいか、最後に列を外したモデルと交差検証で比べて確かめます。
# ↓ さらに続きに書き足して実行します
from sklearn.model_selection import cross_val_score

# --- 「伝票番号」を外したモデルと、全部入りのモデルを5分割交差検証で比べる ---
for cols in [list(X.columns), ["気温", "降水量", "休日"]]:
    rf = RandomForestRegressor(n_estimators=200, random_state=0)
    scores = cross_val_score(rf, X[cols], y, cv=5)  # 回帰では決定係数で採点
    print(f"{len(cols)}列 {cols}: 平均 {scores.mean():.3f}(±{scores.std():.3f})")
4列 ['気温', '降水量', '休日', '伝票番号']: 平均 0.864(±0.009)
3列 ['気温', '降水量', '休日']: 平均 0.860(±0.007)伝票番号を外しても、平均は0.864 → 0.860とほぼ同じです。差の0.004は、ばらつき(±0.009)の範囲に収まっています。外しても困らない列だと確認できました。
⚠️ 注意点もあります。permutation importance は、よく似た列が2つあると、両方とも低く出ることがあります(片方をシャッフルしても、もう片方が代わりを務めるため)。「重要度が低い=消してよい」と決めつけず、サンプル3のように外して性能を確かめる習慣をつけると安心です。
まとめ
feature_importances_は手軽だが、学習データ上の値で、値の種類が多い列を高く見積もりやすいpermutation_importanceはテストデータで列をシャッフルして精度の落ち幅を測るので、関係ない列はほぼ0になる- 説明に使うなら permutation importance を基本にし、ばらつきも一緒に見る
- 列を消すかどうかは、外したモデルを交差検証で比べて決める
「なんとなく出した重要度」が「根拠をもって説明できる重要度」に変わるはずです。手元のデータでも、関係なさそうな列を1つ混ぜて、ぜひ試してみてください! 🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR