データ分析試験のNumPy・pandas頻出ポイント|axis・loc/iloc・NaNの出力予測をコードで確認
「データ分析試験の勉強を始めたけど、NumPy と pandas の問題で毎回ちょっとずつ間違える…」
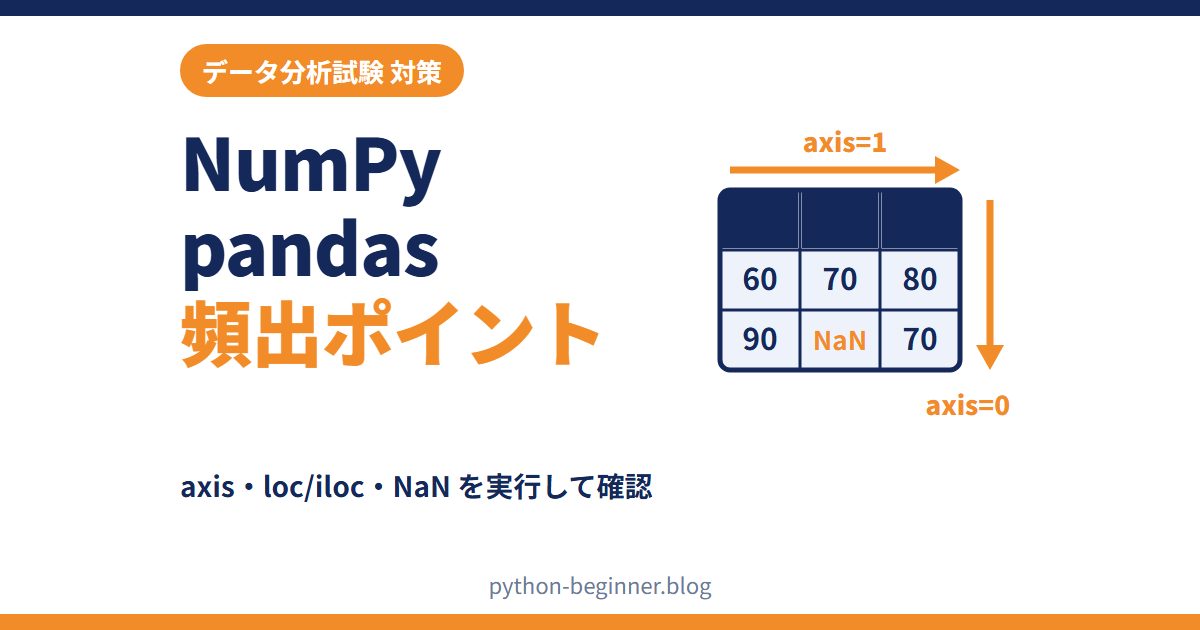
「axis=0 と axis=1、どっちが縦でどっちが横だったっけ?」
こんな悩み、ありますよね。Python 3 エンジニア認定データ分析試験では、NumPy・pandas のコードを読んで「何が出力されるか」を判断する力がそのまま得点に直結します。
この記事は、Python の基本文法はわかる、データ分析試験の受験を考えている初〜中級者向けです。Matplotlib・scikit-learn や数学の話はいったん置いておいて、NumPy・pandas の「出力予測」でつまずきやすいポイントだけに絞って、実際にコードを動かしながら一緒に見ていきましょう!
データ分析試験で NumPy・pandas がなぜ大事なのか
データ分析試験は40問・60分・合格ライン70%、合格率は約81.5%です。数字だけ見ると「受かりやすい試験」に見えますが、主教材「Pythonによるあたらしいデータ分析の教科書」(翔泳社)は NumPy・pandas を使った処理がたくさん出てくる本です。ここがあやふやだと、他の分野の問題でもコードの読み取りで迷ってしまいます。
イメージとしては、NumPy は「数字の表を高速に計算する道具」、pandas は「列名や行ラベルがついた表を扱う道具」です。どちらも「表」を扱うので、行と列のどちら向きに処理するのかを正確に読めるかがカギになります。
講師として受講生の答案を見ていて実感するのは、「関数名は知っているのに、出力の形(shape)を間違える」人がとても多いということです。sum や mean の意味はわかっていても、axis の向きを取り違えて失点する。知識不足というより、手を動かして確かめた回数の差だと感じています。
この記事で確認するポイントをまとめるとこんな感じです👇
- NumPy:shape・ndim・dtype、
axisの向き、reshape(-1)、ブロードキャスト、スライスはビュー - pandas:
locとilocの終端、複数条件の絞り込み、NaN の扱い(count と size の違い)、groupby - ひっかけ5問:実行せずに出力を予想する練習
なお、出題範囲や分野ごとの配分の最新情報は、協会公式サイト(pythonic-exam.com)をご確認ください。
NumPy の頻出ポイント:axis・reshape・ブロードキャスト・ビュー
まずは NumPy です。2人の受講生 × 3回分の小テストの点数を、2行3列の配列にして確認します。
import numpy as np

# 2行3列の配列(例:2人の受講生 × 3回分の小テストの点数)
scores = np.array([[60, 70, 80],
                   [90, 50, 70]])

print("shape:", scores.shape)          # 形(行, 列)
print("ndim:", scores.ndim)            # 次元数
print("dtype:", scores.dtype)          # 要素の型

# axis=0 は「縦方向につぶす」=列ごとの集計
print("axis=0 の合計:", scores.sum(axis=0))
# axis=1 は「横方向につぶす」=行ごとの集計
print("axis=1 の平均:", scores.mean(axis=1))

# reshape の -1 は「残りは自動で計算して」の意味
print(np.arange(6).reshape(3, -1))

# ブロードキャスト:形が違っても自動で広げて計算される
bonus = np.array([5, 0, 10])           # 形は (3,)
print(scores + bonus)                  # (2, 3) + (3,) → (2, 3)

# スライスは「ビュー」:元の配列とデータを共有している
first_row = scores[0, :]
first_row[0] = 0
print("スライスを書き換えた後:", scores[0])

# copy() したものは別物
backup = scores[1, :].copy()
backup[0] = 0
print("copy を書き換えた後:", scores[1])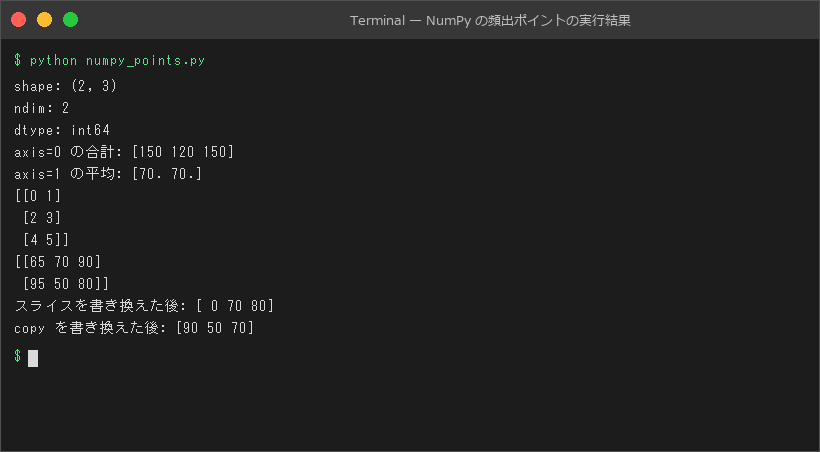
実行結果はこうなりました。
shape: (2, 3)・ndim: 2・dtype: int64axis=0の合計は[150 120 150](列ごと)、axis=1の平均は[70. 70.](行ごと)reshape(3, -1)は3行2列になるscores + bonusは[[65 70 90] [95 50 80]]- スライスを書き換えると元の配列も
[ 0 70 80]に変わり、copy()の方は元が[90 50 70]のまま
ここが重要です👇
axis=0は「縦方向につぶす」ので、結果は列の数(3個)になります。axis=1は「横方向につぶす」ので、行の数(2個)になります。「axis に指定した次元が消える」と覚えると迷いませんmeanの結果は整数の配列でも小数(float)になります。[70. 70.]の「.」に注目ですreshapeの-1は「残りは自動で計算して」の意味。要素6個を3行にするので、列は2になります- ブロードキャスト:形
(3,)のbonusが、(2, 3)に合わせて各行に足されます - スライスはビュー(元データの「のぞき窓」)なので、書き換えると元の配列も変わります。別物にしたいときは
copy()です⚠️
なお dtype の表示は環境によって変わります。今回の環境(Windows・NumPy 2.2.6)では int64 でしたが、Windows で NumPy 1.x を使っていると int32 と表示されます。
pandas の頻出ポイント:loc と iloc・NaN・groupby
続いて pandas です。模試の結果を DataFrame にして、1人だけ未受験(NaN)にしておきます。
import numpy as np
import pandas as pd

# 受講生の模試結果(1人は未受験で NaN)
df = pd.DataFrame(
    {"コース": ["基礎", "基礎", "データ", "データ", "データ"],
     "点数": [72, 65, 88, np.nan, 91]},
    index=["a", "b", "c", "d", "e"],
)
print(df)

# loc はラベル指定:終わりの "c" も含む
print(df.loc["a":"c", "点数"].tolist())
# iloc は位置指定:終わりの 3 は含まない(リストのスライスと同じ)
print(df.iloc[0:3, 1].tolist())

# 条件で絞り込む(複数条件は & と () を使う)
print(df[(df["コース"] == "データ") & (df["点数"] >= 90)])

# NaN は集計から自動で除かれる
print("count:", df["点数"].count(), " size:", df["点数"].size)
print("mean:", df["点数"].mean())

# NaN を埋める・落とす
print(df["点数"].fillna(0).mean())
print(len(df.dropna()))

# groupby でコースごとに集計
print(df.groupby("コース")["点数"].agg(["count", "mean"]))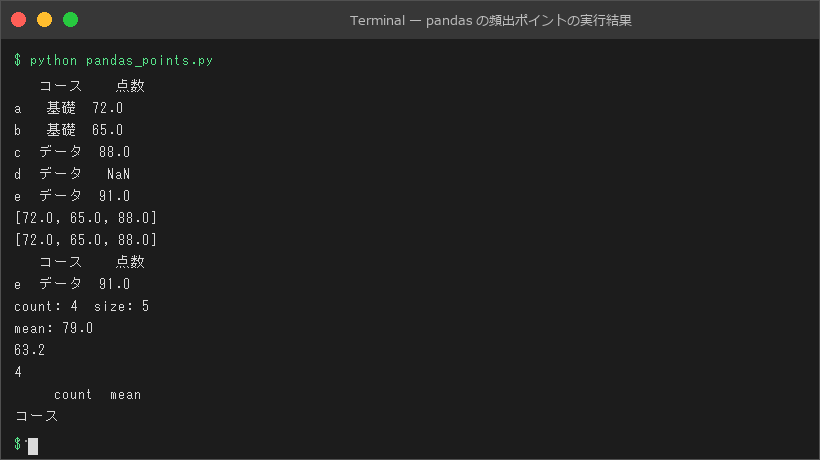
ポイントをまとめるとこんな感じです👇
locはラベル指定で、終わり("c")を含みます。ilocは位置指定で、終わり(3)を含みません。どちらも[72.0, 65.0, 88.0]になっているのは、同じ3行を取るのに"a":"c"と0:3で書き方が違うからです- 点数の列に NaN が1つあるので、列全体がfloatになり、
72ではなく72.0と表示されます - 複数条件は
andではなく&、それぞれの条件は()で囲む。andを使うとエラーになります count()は NaN を数えず 4、sizeは NaN も含めて 5。mean()も NaN を除いた4人の平均で79.0ですfillna(0)で NaN を0点として扱うと、5人の平均で63.2に下がります。dropna()は NaN を含む行を落とすので4行groupbyの結果は、グループのキー(ここでは「コース」)がインデックスになります
講師としての実感でいうと、pandas で一番点を落としやすいのは loc の終端です。Python のリストのスライスに慣れている人ほど「終わりは含まない」と反射的に考えてしまうんですよね。「loc はラベル=含む、iloc は位置=含まない」をセットで覚えておきましょう。
実行せずに答えられますか? NumPy・pandas ひっかけ5問
ここで腕試しです。次のコードの出力を、実行せずに予想してみてください😊
import numpy as np
import pandas as pd

# Q1:形はどうなる?
a = np.zeros((2, 3))
print("Q1:", a.reshape(-1).shape)

# Q2:整数の配列を 2 で割ると?
b = np.array([1, 2, 3])
print("Q2:", b / 2, b // 2)

# Q3:axis=1 で最大値の「位置」を取ると?
c = np.array([[3, 9, 1],
              [7, 2, 8]])
print("Q3:", c.argmax(axis=1))

# Q4:Series の足し算はインデックスで揃う
s1 = pd.Series([1, 2], index=["x", "y"])
s2 = pd.Series([10, 20], index=["y", "z"])
print("Q4:")
print(s1 + s2)

# Q5:value_counts の並び順は?
s = pd.Series(["A", "B", "A", "C", "A", "B"])
print("Q5:")
print(s.value_counts())
答えを確認する前に、紙に書き出してみるのがおすすめです。
答えと解説
実際に実行した結果をまとめると、こうなりました。
| 問題 | 出力 | ポイント |
|---|---|---|
| Q1 | (6,) |
reshape(-1) は1次元にする。(2, 3) の要素6個が1列に並ぶ |
| Q2 | [0.5 1. 1.5] と [0 1 1] |
/ は整数どうしでも小数になる。// は切り捨て |
| Q3 | [1 2] |
argmax は最大値そのものではなく位置。1行目は9が1番目、2行目は8が2番目(0始まり) |
| Q4 | x NaN / y 12.0 / z NaN |
Series の計算はインデックスで揃えて行われる。片方にしかない x・z は NaN、NaN が入るので float になる |
| Q5 | A 3 / B 2 / C 1 |
value_counts は多い順に並ぶ。今回の環境(pandas 3.0.3)では最後に Name: count と表示された |
Q4 は特にひっかかりやすい問題です。リストの感覚で「上から順に足す」と考えると 11, 22 のような答えを選んでしまいます。pandas は位置ではなくラベルで対応をとる、ここが NumPy との大きな違いです。
Q5 の Name: count のように、表示の細かい部分はバージョンによって変わることがあります。試験対策としては、表示の見た目よりも「多い順に並ぶ」「NaN が入ると float になる」といった動きの理由を押さえておくのが大事です。
試験直前に見直したいチェックリスト
最後に、今回のポイントを試験前に見直せる形にまとめておきます。
- □
axis=0は列ごと、axis=1は行ごとの集計になる(指定した次元が消える) - □
meanや/の結果は float になる。//は切り捨て - □
reshapeの-1は「自動で計算」。reshape(-1)は1次元化 - □ 形が違う配列どうしでもブロードキャストで計算できることがある
- □ NumPy のスライスはビュー。独立させるなら
copy() - □
locは終端を含む、ilocは含まない - □ 複数条件は
&と|、各条件を()で囲む - □
count()は NaN を数えない、sizeは数える。mean()は NaN を除いて計算 - □ Series の演算はインデックスで揃う。片方にしかないラベルは NaN
- □
argmaxは位置、value_countsは多い順
こうした「出力予測」の問題は、本番と同じ形式の問題をたくさん解いて慣れるのが近道です。筆者が運営するデータ分析試験 対策コースでは、本試験形式の模擬試験で NumPy・pandas を含めた出題を練習できます(協会非公認の独自教材です)。教科書で読んだ内容を、問題を解きながら確認したい方は参考にしてみてください。
まとめ
今回は、データ分析試験の NumPy・pandas で差がつくポイントを、実際にコードを動かして確認しました。
- NumPy は
axisの向き・reshape(-1)・ブロードキャスト・ビューを押さえる - pandas は
loc/ilocの終端・NaN の扱い・インデックスで揃う演算がひっかけの定番 - 「関数を知っている」だけでなく、出力の形と型(int か float か)まで予想できる状態を目指す
どれも、コードを1回動かせば「なるほど」と納得できるものばかりです。記事のコードをコピーして値を少し変えながら、ぜひ試してみてください。「むずかしそう」を「できそう」に変える一番の近道です🚀
よくある質問
Q1. NumPy と pandas、どちらを先に勉強すべきですか?
NumPy からがおすすめです。pandas の DataFrame は NumPy の配列を土台にしていて、axis の考え方や「NaN を含むと float になる」動きなど、NumPy の理解がそのまま pandas に生きます。
Q2. 関数の引数まで全部暗記する必要がありますか?
全部を暗記する必要はありません。まずは axis、loc/iloc、dropna/fillna、groupby など、教科書によく出てくるものを「実行結果を予想できる」レベルにするのが効率的です。
Q3. 手元のバージョンで表示が教科書と少し違うのですが大丈夫ですか?
NumPy・pandas はバージョンによって表示の細部(dtype や Name: の行など)が変わることがあります。試験対策では、表示の見た目よりも動きの理由を理解することを優先しましょう。試験の実施要項など最新の情報は協会公式サイトをご確認ください。
\ 受験前に、今の実力を無料でチェック /
本記事の筆者が運営する試験対策の専門サービスでは、本番と同じ形式の模擬試験(基礎・実践・データ分析 各1回分)を無料で受験できます。クレジットカードの登録は不要です。
▶ 試験の全体像・勉強法のまとめは完全ガイドへ
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR