Python×scikit-learnのk-meansで顧客をグループ分け!標準化とグループ数の決め方まで解説
「お客さんのデータはあるけど、どう分析すればいいか分からない…」「機械学習って、正解データを用意しないと始められないんでしょ?」──そんなふうに思っていませんか?
実は、正解ラベルがなくても使える機械学習があります。それが今回の主役、k-means(ケーミーンズ)クラスタリングです。この記事では、scikit-learnを使って購買データから顧客を自動でグループ分けしてみます。
難易度はPython初〜中級者向け。pandasでCSVを読み込んだことがあれば大丈夫です😊 初心者がつまずきやすい「標準化しないと失敗する問題」と、グループ数の決め方(エルボー法・シルエット分析)まで、実際に動かした結果を見ながら一緒に見ていきましょう!
k-meansクラスタリングとは?
イメージとしては、「似たもの同士を、指定した数のグループに自動で分ける」方法です。
「これは食費」「これは交通費」のような正解付きのデータで学習する「分類」は、教師あり学習と呼ばれます。一方、k-meansは教師なし学習なので、正解は不要です。データの「近さ」だけを手がかりに、グループを見つけ出してくれます。
動きはシンプルで、次の3ステップをくり返すだけです。
- グループの「中心点」を k 個、仮に置く
- 各データを、いちばん近い中心点のグループに入れる
- グループごとに平均を取り、中心点をそこへ移動する(2に戻る。中心がほとんど動かなくなったら終了)
つまり「近い中心に集まる → 中心を真ん中に動かす」をくり返して、きれいにまとまる位置を探す、というわけです。k(グループ数)は人間が決める、というのがポイントで、後半でその決め方を解説します。
準備:ライブラリのインストール
使うのは scikit-learn・pandas・matplotlib の3つです。まだの方はインストールしておきましょう。
pip install scikit-learn pandas matplotlib
この記事のコードは、Python 3.13・scikit-learn 1.9.0・pandas 3.0.3・matplotlib 3.11.0 で動作を確認しています。
ステップ1:練習用の顧客データを作る
本物の顧客データは手元にないことが多いので、まずは練習用のデータを作ります。「年間購入回数」と「平均購入金額」の2項目を持つ、200人分のお店の顧客データです。
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)  # 乱数を固定して、毎回同じデータにする

# (人数, 平均購入回数, 回数のばらつき, 平均購入金額, 金額のばらつき)
groups = [
    (80, 3, 1.5, 2500, 700),    # たまに少しだけ買う人
    (60, 24, 4, 2000, 600),     # よく来るけど少額の人
    (40, 5, 2, 9000, 1200),     # たまに来て高額を買う人
    (20, 20, 3, 8000, 1000),    # よく来て高額も買う人
]

rows = []
for n, freq, freq_sd, amount, amount_sd in groups:
    f = rng.normal(freq, freq_sd, n).clip(1).round().astype(int)  # 回数は1回以上の整数
    a = rng.normal(amount, amount_sd, n).clip(500).round(-1).astype(int)  # 金額は10円単位
    rows.append(pd.DataFrame({"年間購入回数": f, "平均購入金額": a}))

df = pd.concat(rows, ignore_index=True)
df = df.sample(frac=1, random_state=0).reset_index(drop=True)  # 行をシャッフル
df.insert(0, "顧客ID", [f"C{i:03d}" for i in range(1, len(df) + 1)])
df.to_csv("customers.csv", index=False, encoding="utf-8-sig")

print(df.head())
print(f"\n顧客数: {len(df)}人")
print(df[["年間購入回数", "平均購入金額"]].describe().round(1))
ポイントをまとめるとこんな感じです。
np.random.default_rng(42)で乱数を固定しているので、何度実行しても同じデータになります- 実はこっそり4タイプの顧客を混ぜてあります。k-meansがこれを正しく見つけられるかが見どころです
- 最後に
customers.csvに保存し、以降のコードはこのCSVを読み込みます
実行すると、先頭5行はこうなりました(describe() の要約統計も一緒に表示されます)。
| 顧客ID | 年間購入回数 | 平均購入金額 |
|---|---|---|
| C001 | 4 | 2780 |
| C002 | 7 | 9440 |
| C003 | 19 | 3100 |
| C004 | 24 | 1360 |
| C005 | 4 | 9320 |
要約統計を見ると、年間購入回数は1〜33回、平均購入金額は710〜11,180円でした。ここ、あとで効いてくるので覚えておいてください👀
ステップ2:標準化しないとk-meansは失敗する
さっそくk-meansにかけてみましょう。ここでは、データをそのまま使った場合と標準化してから使った場合を並べて比べます。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

plt.rcParams["font.family"] = "Meiryo"  # 日本語を表示するため(Macなら "Hiragino Sans")

df = pd.read_csv("customers.csv")
X = df[["年間購入回数", "平均購入金額"]]

# ① そのままk-meansにかける
labels_raw = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(X)

# ② 標準化(平均0・標準偏差1にそろえる)してからk-meansにかける
X_scaled = StandardScaler().fit_transform(X)
labels_scaled = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(X_scaled)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))
for ax, labels, title in zip(axes, [labels_raw, labels_scaled],
                             ["① 標準化なし", "② 標準化あり"]):
    ax.scatter(X["年間購入回数"], X["平均購入金額"], c=labels, cmap="tab10", vmax=9, s=25)
    ax.set_title(title)
    ax.set_xlabel("年間購入回数(回)")
    ax.set_ylabel("平均購入金額(円)")
plt.tight_layout()
plt.show()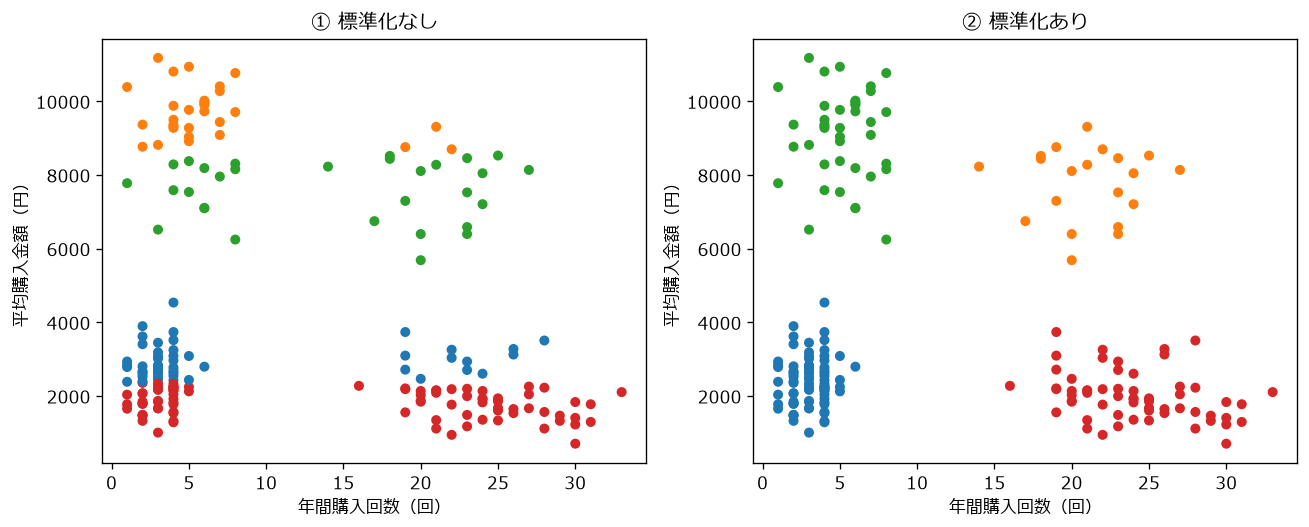
左の「① 標準化なし」を見てください。4グループに分かれてはいるものの、ほぼ横向きの線で上下に切られているだけですよね。左下と右下の、まったく性格の違うお客さんが同じ色になっています。
原因は数値の大きさ(スケール)の違いです。k-meansは「距離」でグループを決めますが、購入回数の差は最大でも30回ほど、金額の差は1万円以上あります。そのまま距離を計算すると、金額の差ばかりが効いて、回数はほとんど無視されるのです。
そこで使うのが StandardScaler による標準化です。つまり、各項目を「平均0・標準偏差1」にそろえて、どちらの項目も同じ重みで距離に効くようにします。右の「② 標準化あり」では、4つのかたまりがきれいに分かれました🚀
ここが重要です👇
- k-meansなど距離を使う手法では、標準化はほぼ必須
n_init=10は「初期位置を変えて10回試し、いちばん良い結果を採用する」設定。k-meansは最初の中心点の置き方で結果が変わることがあるためですrandom_state=0を指定すると、毎回同じ結果が再現できます
ステップ3:グループ数kを決める(エルボー法・シルエット分析)
今回は「4タイプを混ぜた」と知っているので k=4 にしましたが、実際のデータでは何グループあるか分からないのが普通です。そこで、k を2〜8まで変えて、2つの指標で比べてみます。
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
from sklearn.preprocessing import StandardScaler

df = pd.read_csv("customers.csv")
X_scaled = StandardScaler().fit_transform(df[["年間購入回数", "平均購入金額"]])

print(" k |  inertia | シルエット係数")
for k in range(2, 9):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X_scaled)
    score = silhouette_score(X_scaled, km.labels_)
    print(f"{k:2d} | {km.inertia_:8.1f} | {score:.3f}")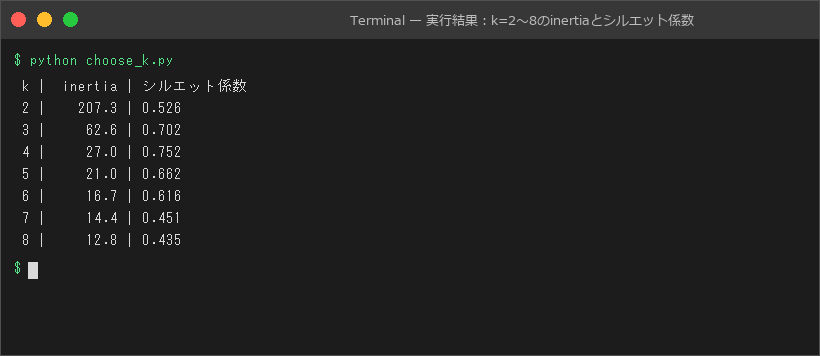
2つの指標の意味は次のとおりです。
| 指標 | 意味 | 見方 |
|---|---|---|
| inertia | 各データと、所属グループの中心との距離の2乗の合計 | 小さいほどまとまっている。ただし k を増やすとほぼ小さくなっていく |
| シルエット係数 | 「自分のグループ内の近さ」と「隣のグループとの離れ具合」を比べた値(-1〜1) | 1に近いほど、きれいに分かれている |
inertiaは k=2→3 で207.3→62.6、3→4 で62.6→27.0と大きく下がり、k=4 以降は下がり方がゆるやか(27.0→21.0→16.7…)になりました。この「ガクッと曲がるひじ(エルボー)の位置」を選ぶのがエルボー法です。
シルエット係数も k=4 の0.752が最大でした。2つの指標がそろって k=4 を指しているので、自信を持って4グループに決められますね😊
⚠️ 実際のデータでは、ここまできれいに答えが出ないこともよくあります。そのときは候補のkをいくつか試して、「そのグループ分けで施策を考えやすいか」という実用面もあわせて判断しましょう。
ステップ4:4グループに分けて、特徴を読み取る
k=4 で本番のグループ分けをして、各グループの平均と人数を集計します。グラフには各グループの中心点も描きます。
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

plt.rcParams["font.family"] = "Meiryo"

df = pd.read_csv("customers.csv")
features = ["年間購入回数", "平均購入金額"]

scaler = StandardScaler()
X_scaled = scaler.fit_transform(df[features])
km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(X_scaled)
df["グループ"] = km.labels_

# グループごとの人数と平均を集計
summary = df.groupby("グループ")[features].mean().round(1)
summary["人数"] = df["グループ"].value_counts().sort_index()
print(summary)

# 中心点を「元の単位(回・円)」に戻す
centers = scaler.inverse_transform(km.cluster_centers_)

plt.figure(figsize=(7, 5))
plt.scatter(df["年間購入回数"], df["平均購入金額"], c=df["グループ"], cmap="tab10", vmax=9, s=25)
plt.scatter(centers[:, 0], centers[:, 1], marker="X", s=250, c="black", label="各グループの中心")
for i, (x, y) in enumerate(centers):
    plt.annotate(f"グループ{i}", (x, y), xytext=(10, 10), textcoords="offset points", fontsize=12,
                 bbox=dict(boxstyle="round", fc="white", alpha=0.8))
plt.xlabel("年間購入回数(回)")
plt.ylabel("平均購入金額(円)")
plt.title("k-meansで顧客を4グループに分けた結果")
plt.legend()
plt.show()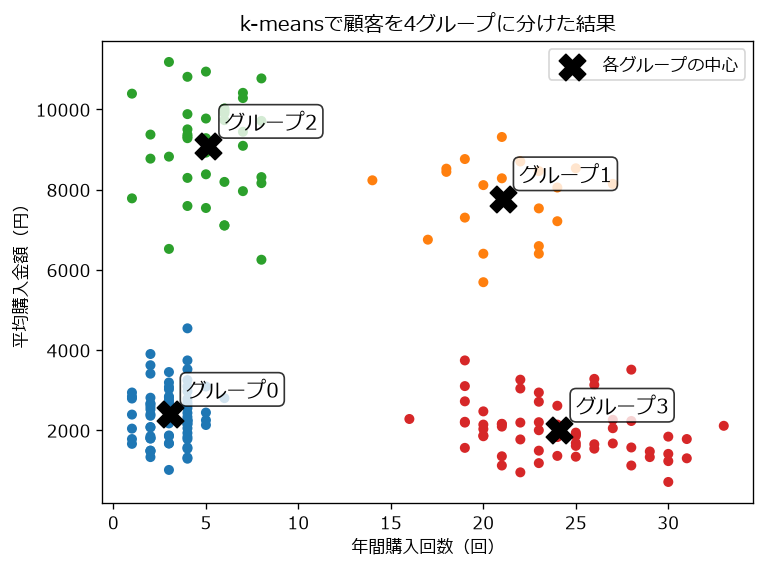
集計結果(print(summary) の出力)は次のとおりです。
| グループ | 年間購入回数(平均) | 平均購入金額(平均) | 人数 |
|---|---|---|---|
| 0 | 3.0回 | 2,396.4円 | 80人 |
| 1 | 21.0回 | 7,770.0円 | 20人 |
| 2 | 5.1回 | 9,077.2円 | 40人 |
| 3 | 24.1回 | 2,001.3円 | 60人 |
人数が80・20・40・60人と、データを作るときに混ぜた4タイプの人数とぴったり一致しました。正解を教えていないのに、k-meansが4タイプを見つけ出せたということです。
ポイントをまとめるとこんな感じです。
km.labels_に、各顧客が何番のグループに入ったかが入っているkm.cluster_centers_は標準化後の座標なので、scaler.inverse_transform()で「回・円」の単位に戻してからグラフに描いている- グループ番号(0〜3)そのものには意味がありません。データや設定を変えると番号は入れ替わることがあります
ステップ5:グループに名前を付けて、新しい顧客を判定する
番号のままでは使いにくいので、中心点の値から「常連・高単価」のような名前を付けます。さらに、学習に使っていない新しい顧客がどのグループに入るかも判定してみましょう。
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

df = pd.read_csv("customers.csv")
features = ["年間購入回数", "平均購入金額"]

scaler = StandardScaler()
km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(scaler.fit_transform(df[features]))

# 中心点(元の単位)を見て、グループに名前を付ける
def name_group(freq, amount):
    kind = "常連" if freq >= 12 else "ライト"
    price = "高単価" if amount >= 5000 else "低単価"
    return f"{kind}・{price}"

centers = scaler.inverse_transform(km.cluster_centers_)
names = {i: name_group(f, a) for i, (f, a) in enumerate(centers)}
for i, (f, a) in enumerate(centers):
    print(f"グループ{i}: {names[i]}(中心: {f:.1f}回 / {a:,.0f}円)")

# 新しい顧客がどのグループに入るか判定する
new_customers = pd.DataFrame(
    {"年間購入回数": [2, 18, 26], "平均購入金額": [8500, 7000, 1500]},
    index=["新規A", "新規B", "新規C"],
)
pred = km.predict(scaler.transform(new_customers))  # 学習時と同じscalerで変換する
new_customers["判定"] = [names[p] for p in pred]
print()
print(new_customers)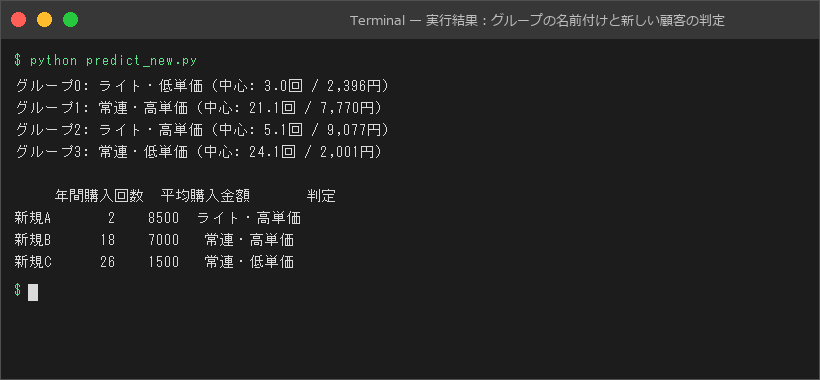
新規Aは「年2回だけど1回8,500円」なのでライト・高単価、新規Cは「年26回・1回1,500円」なので常連・低単価と、グラフで見た感覚どおりに判定されました。
ここが重要です👇
- 新しいデータは
scaler.fit_transform()ではなくscaler.transform()で変換する。学習時の平均・標準偏差を使わないと、物差しがずれてしまいます - 名前付けのしきい値(12回・5,000円)は、中心点の値を見て人間が決めたもの。k-meansが決めてくれるのは「グループ分け」までで、意味づけは人間の仕事です
- グループが分かれば、「ライト・高単価の人には来店のきっかけになるクーポン」「常連・低単価の人にはまとめ買い特典」のように、グループごとに打ち手を変えることができます
自分のデータで試すときの注意点
- 外れ値に弱い:平均で中心を決めるため、極端な値(1回に100万円買った人など)があると中心が引っ張られます。事前にグラフで確認しましょう
- 丸いかたまり向き:k-meansは中心からの距離で分けるので、細長い形や三日月形のグループはうまく分けられません
- 項目を増やしてもOK:「最終購入からの日数」などを列に足せば、3項目以上でも同じ流れで分析できます(グラフは2項目ずつ描くことになります)
まとめ
- k-meansは、正解ラベルなしで似たデータを k 個のグループに分ける教師なし学習
- 距離を使うので、StandardScalerでの標準化はほぼ必須。しないと金額だけで分けられてしまう
- グループ数kは、エルボー法(inertia)とシルエット係数を見て決める
- 中心点を
inverse_transform()で元の単位に戻すと、グループの特徴を読み取りやすい - 新しいデータは
transform()→predict()でグループを判定できる
「機械学習はむずかしそう」と思っていた方も、コード数十行で顧客の分析ができることが分かったのではないでしょうか。ざっくりとした流れがつかめたら、ぜひ自分の手元のデータでも試してみてください😊
参考:scikit-learn公式ドキュメント(K-means)
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR