scikit-learnのPipeline入門!欠損値・カテゴリ列の前処理をまとめて新データのエラーとデータリークを防ぐ
「scikit-learnで学習はできたけど、新しいデータで予測しようとしたらエラーが出た…」
「欠損値の穴埋めやダミー変数化を、毎回コピペで書いていてごちゃごちゃする」
機械学習を少し触った人なら、一度はこんな経験がありますよね。実は、この悩みはscikit-learnのPipeline(パイプライン)とColumnTransformerでまとめて解決できます😊
この記事では、ジム会員が「退会しそうか」を予測する小さな題材を使って、次の順に一緒に見ていきましょう!
- 手作業の前処理だと、新しいデータでどこが壊れるのか
- Pipeline・ColumnTransformerで前処理とモデルを1本にまとめる方法
- 気づかないうちに精度を「盛ってしまう」データリークの実験
- GridSearchCVでの設定探索と、前処理ごとのモデル保存
対象読者:scikit-learnで fit / predict を一度は動かしたことがある初〜中級者です。動作確認は Python 3.13・scikit-learn 1.9.0・pandas 3.0.3 で行いました。
Pipelineとは?「前処理からモデルまでの流れ」を1つの部品にするもの
イメージとしては、工場のベルトコンベアです。「欠損を埋める → 数値の大きさをそろえる → カテゴリを数値に変える → モデルで予測」という工程を順番に並べて、1台の機械として扱えるようにします。
つまり、Pipelineにしておけば fit と predict を呼ぶだけで、学習時とまったく同じ前処理が新しいデータにも自動でかかります。
| 部品 | 役割 |
|---|---|
Pipeline |
処理を「順番に」つなぐ |
ColumnTransformer |
「列ごとに」別の前処理を振り分ける(数値の列はこっち、文字の列はあっち) |
SimpleImputer |
欠損値を平均・中央値・最頻値などで埋める |
OneHotEncoder |
「ライト / スタンダード」のような文字のカテゴリを0と1の列に変える |
準備:欠損ありのジム会員データを作る
まずは練習用のデータを作ります。年齢・月の来店回数・在籍月数・プラン・支払い方法の5列と、正解の「退会(1=退会した)」列を持つ400人分のデータです。本物のデータらしく、わざと一部を欠損させています。
ポイントをまとめるとこんな感じです👇
- 「来店が少ない・在籍が短い・ライトプラン」の人ほど退会しやすいルールで正解を作る
- 年齢・来店回数・プランの一部を
NaN(欠損)にする members.csvとして保存する
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
n = 400

# ジム会員のデータを作る(年齢・月の来店回数・在籍月数・プラン・支払い方法)
df = pd.DataFrame({
    "年齢": rng.integers(18, 70, n).astype(float),
    "月の来店回数": rng.poisson(6, n).astype(float),
    "在籍月数": rng.integers(1, 48, n).astype(float),
    "プラン": rng.choice(["ライト", "スタンダード", "プレミアム"], n, p=[0.4, 0.4, 0.2]),
    "支払い方法": rng.choice(["カード", "口座振替"], n),
})

# 来店が少ない・在籍が短い・ライトプランの人ほど退会しやすい、というルールで正解を作る
score = (-0.5 * df["月の来店回数"] - 0.05 * df["在籍月数"]
         + (df["プラン"] == "ライト") * 1.0 + rng.normal(0, 1, n) + 3.5)
df["退会"] = (score > 0).astype(int)

# 実際のデータらしく、一部を欠損させる
df.loc[rng.choice(n, 30, replace=False), "年齢"] = np.nan
df.loc[rng.choice(n, 20, replace=False), "月の来店回数"] = np.nan
df.loc[rng.choice(n, 15, replace=False), "プラン"] = np.nan

df.to_csv("members.csv", index=False, encoding="utf-8-sig")
print(df.head())
print("---- 欠損の数 ----")
print(df.isna().sum())
print("退会率:", round(df["退会"].mean(), 3))
実行すると、こうなりました。
     年齢  月の来店回数  在籍月数     プラン 支払い方法  退会
0  22.0     4.0  14.0  スタンダード  口座振替   1
1  58.0     4.0  36.0   プレミアム   カード   1
2  52.0     7.0   4.0  スタンダード   カード   1
3  40.0     8.0   4.0     ライト  口座振替   1
4  40.0     4.0  19.0     ライト  口座振替   1
---- 欠損の数 ----
年齢        30
月の来店回数    20
在籍月数       0
プラン       15
支払い方法      0
退会         0
dtype: int64
退会率: 0.418
数値の列にも、文字の列(プラン)にも欠損がありますね。この「数値と文字が混ざっていて、しかも欠損がある」状態が、前処理を面倒にする原因です。
手作業の前処理だと、新しいデータで壊れる
まずはPipelineを使わずに、よくある書き方で学習してみます。欠損は平均で埋め、カテゴリ列は pd.get_dummies でダミー変数にします。そのあと、新しく入会した1人を予測してみましょう。
これ、実行せずに結果を予想できますか?🤔
import pandas as pd
from sklearn.linear_model import LogisticRegression

df = pd.read_csv("members.csv")
X = df.drop(columns="退会")
y = df["退会"]

# 手作業で前処理:欠損を平均で埋めて、カテゴリ列をダミー変数に
X = X.fillna(X.mean(numeric_only=True))
X = pd.get_dummies(X, columns=["プラン", "支払い方法"])
model = LogisticRegression(max_iter=1000).fit(X, y)
print("学習に使った列:", list(X.columns))

# 新しく入会した1人を予測したい
new = pd.DataFrame([{"年齢": 35, "月の来店回数": 2, "在籍月数": 3,
                     "プラン": "ライト", "支払い方法": "カード"}])
new = pd.get_dummies(new, columns=["プラン", "支払い方法"])
print("新データの列 :", list(new.columns))
print(model.predict(new))
実行結果です(エラーの途中は省略しています)。
学習に使った列: ['年齢', '月の来店回数', '在籍月数', 'プラン_スタンダード', 'プラン_プレミアム', 'プラン_ライト', '支払い方法_カード', '支払い方法_口座振替']
新データの列 : ['年齢', '月の来店回数', '在籍月数', 'プラン_ライト', '支払い方法_カード']
Traceback (most recent call last):
  (途中省略)
ValueError: The feature names should match those that were passed during fit.
Feature names seen at fit time, yet now missing:
- プラン_スタンダード
- プラン_プレミアム
- 支払い方法_口座振替
エラーになりました⚠️ 原因は、列の数が合っていないことです。
- 学習データには「ライト・スタンダード・プレミアム」が全部あったので、プランのダミー列が3つできた
- 新しいデータは「ライト」の1人だけなので、
get_dummiesはプラン_ライトの1列しか作らない - モデルは「学習のときと同じ列をください」と言っているのに、列が足りない
さらに、新データに欠損があったら? 埋めるのは「学習データの平均」のはずなのに、うっかり新データの平均で埋めてしまう…というミスも起きがちです。前処理で覚えた値(平均やカテゴリの一覧)を、予測のときにも同じように使う必要があるわけですね。
PipelineとColumnTransformerで前処理をまとめる
同じことをPipelineで書き直します。ここが重要です👇
- 数値列は「中央値で穴埋め → 標準化」、カテゴリ列は「最頻値で穴埋め → ワンホット」と、列ごとに担当を決める
OneHotEncoder(handle_unknown="ignore")にすると、学習時に無かったカテゴリが来てもエラーにならない(そのカテゴリの列はすべて0として扱う)- 最後に前処理とモデルを
Pipelineでつなぐと、clf.fit()/clf.predict_proba()だけで全部動く
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

df = pd.read_csv("members.csv")
X = df.drop(columns="退会")
y = df["退会"]

num_cols = ["年齢", "月の来店回数", "在籍月数"]
cat_cols = ["プラン", "支払い方法"]

# 数値列:欠損を中央値で埋める → 標準化
num_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
])
# カテゴリ列:欠損を最頻値で埋める → ワンホット(知らない値は無視)
cat_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore")),
])
# 列ごとに担当を振り分ける
prep = ColumnTransformer([
    ("num", num_pipe, num_cols),
    ("cat", cat_pipe, cat_cols),
])
# 前処理とモデルを1本につなぐ
clf = Pipeline([
    ("prep", prep),
    ("model", LogisticRegression(max_iter=1000)),
])

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=0, stratify=y)
clf.fit(X_train, y_train)
print("テストデータの正解率:", round(clf.score(X_test, y_test), 3))

# 新しい会員(欠損あり・学習時に無かったプラン名もあり)
new = pd.DataFrame([
    {"年齢": 35, "月の来店回数": 2, "在籍月数": 3, "プラン": "ライト", "支払い方法": "カード"},
    {"年齢": None, "月の来店回数": 12, "在籍月数": 30, "プラン": "プレミアム", "支払い方法": "口座振替"},
    {"年齢": 28, "月の来店回数": 5, "在籍月数": 10, "プラン": "学生", "支払い方法": "カード"},
])
proba = clf.predict_proba(new)[:, 1]
for i, p in enumerate(proba):
    print(f"会員{i + 1}: 退会確率 {p:.0%}")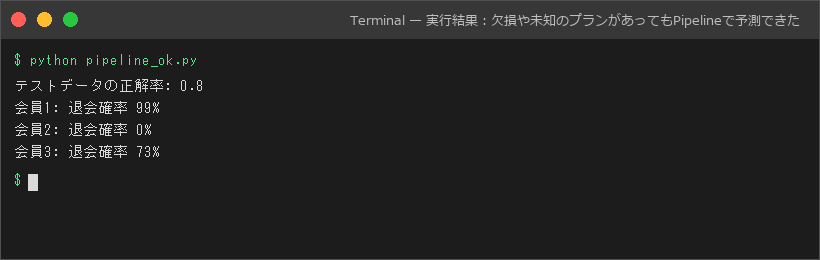
新しい会員3人には、わざと「年齢が欠損している人」と「学習データに無い『学生』プランの人」を混ぜています。実行結果は上の画像のとおりです。
今度はエラーになりませんでした🚀 新データを数人分だけ渡しても、欠損があっても、知らないプラン名が来ても、学習時に覚えた中央値・最頻値・カテゴリ一覧を使って同じ前処理がかかっています。
結果も、来店2回・在籍3か月・ライトプランの会員1は退会確率99%、来店12回・在籍30か月の会員2は0%と、データを作ったときのルールどおりの傾向になっています。
なお、テストデータの正解率が0.8なのは、作ったデータに乱数のノイズを入れているためです。今回はPipelineの使い方が主役なので、精度の高さはあまり気にしなくて大丈夫です。
実験:前処理を先にやると、精度が「盛られる」(データリーク)
Pipelineには、エラーを防ぐ以外にもう1つ大事な役割があります。それがデータリーク(情報漏れ)を防ぐことです。
データリークとは、つまり「テスト用に取っておいたはずのデータの情報が、学習のときに混ざってしまうこと」です。テストの問題を先に見てから勉強するようなもので、点数だけ良く見えて本番では役に立ちません。
極端な例で試してみましょう。正解ラベルも特徴量も完全にランダムなデータです。本来なら、どう頑張っても正解率は50%前後にしかならないはずですよね。
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline

rng = np.random.default_rng(0)
# 100人分・特徴量5000個の「完全なデタラメ」データ。正解ラベルもランダム
X = rng.normal(size=(100, 5000))
y = rng.integers(0, 2, 100)

# NG:全データを見て「正解と関係ありそうな20列」を先に選んでから交差検証
X_selected = SelectKBest(f_classif, k=20).fit_transform(X, y)
ng = cross_val_score(LogisticRegression(), X_selected, y, cv=5)
print("NG(先に列を選んだ)    :", round(ng.mean(), 3))

# OK:列の選択もパイプラインに入れて、交差検証の学習用データだけで選ぶ
pipe = Pipeline([
    ("select", SelectKBest(f_classif, k=20)),
    ("model", LogisticRegression()),
])
ok = cross_val_score(pipe, X, y, cv=5)
print("OK(パイプラインで選んだ):", round(ok.mean(), 3))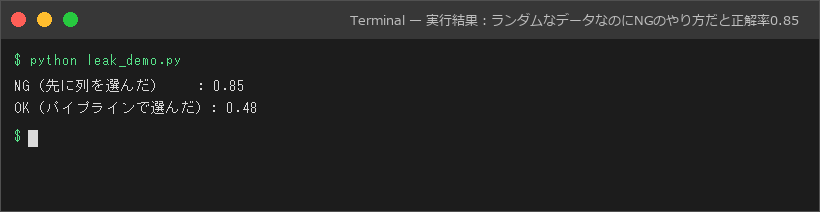
実行結果(上の画像)を見ると、デタラメなデータなのに、NGのやり方では正解率0.85(85%)と出てしまいました😱 一方、Pipelineに入れたほうは0.48で、ちゃんと「当てずっぽうと同じ」という正しい結果になっています。
何が起きたのかを整理すると、こんな感じです👇
- NGのほうは、交差検証で「テスト役」になるデータも含めた全データを見て、「たまたま正解と相関がある20列」を選んでいた
- その時点でテスト役の答えを覗いているので、交差検証の点数が不当に高くなる
- Pipelineに入れると、交差検証の各回で学習役のデータだけを使って列を選ぶので、覗き見が起きない
今回は差が分かりやすい特徴量選択で試しましたが、欠損の穴埋めや標準化でも理屈は同じです(影響は小さめなことが多いですが、ゼロではありません)。「データを見て何かを覚える処理」は全部Pipelineの中に入れる、と覚えておけば安心です。
GridSearchCVで設定を探して、前処理ごと保存する
Pipelineにしておくと、ハイパーパラメータ探索もそのままできます。前の pipeline_ok.py の末尾に、次のコードを書き足して実行してみましょう。
ポイントは、パラメータ名を「ステップ名__パラメータ名」(アンダースコア2つ)で書くことです。
model__C→modelステップ(ロジスティック回帰)のCprep__num__imputer__strategy→prepの中のnumの中のimputerのstrategy
# ===== ここから pipeline_ok.py の末尾に追記 =====
import joblib
from sklearn.model_selection import GridSearchCV

# 「ステップ名__パラメータ名」で、パイプラインの奥の設定も探索できる
param_grid = {
    "prep__num__imputer__strategy": ["mean", "median"],
    "model__C": [0.01, 0.1, 1, 10],
}
search = GridSearchCV(clf, param_grid, cv=5)
search.fit(X_train, y_train)  # 学習用データだけで探索する
print("いちばん良かった設定:", search.best_params_)
print("交差検証の平均正解率:", round(search.best_score_, 3))
print("テストデータの正解率:", round(search.score(X_test, y_test), 3))

# 前処理ごと1ファイルに保存して、読み込み直して使う
joblib.dump(search.best_estimator_, "churn_model.joblib")
loaded = joblib.load("churn_model.joblib")
new2 = pd.DataFrame([{"年齢": 45, "月の来店回数": 1, "在籍月数": 2,
                      "プラン": None, "支払い方法": "カード"}])
print("読み込んだモデルで予測:", loaded.predict(new2))
実行結果です(前半の4行は、書き足す前の部分の出力です)。
テストデータの正解率: 0.8
会員1: 退会確率 99%
会員2: 退会確率 0%
会員3: 退会確率 73%
いちばん良かった設定: {'model__C': 0.1, 'prep__num__imputer__strategy': 'mean'}
交差検証の平均正解率: 0.797
テストデータの正解率: 0.82
読み込んだモデルで予測: [1]
穴埋めの方法(平均か中央値か)とモデルの C の組み合わせ8通りを試して、一番良い設定を自動で選んでくれました。探索中の交差検証も、さきほどのリーク対策と同じく「学習役のデータだけで前処理を覚える」形で行われます。
そして joblib.dump で保存したファイルには、前処理(中央値・カテゴリ一覧など)とモデルがまとめて入っています。読み込んだ側は、プランが欠損したままのデータをそのまま渡すだけで予測できました。Webアプリなど別のプログラムから使うときに、前処理のコードを書き直さなくていいのは大きいですよね。
⚠️ joblibで保存したファイルは、保存したときとscikit-learnのバージョンが違う環境では読み込めなかったり、動きが変わったりすることがあります。また、読み込み時に任意のコードが実行される可能性があるので、信頼できない人からもらったファイルは読み込まないようにしましょう。詳しくはscikit-learn公式ドキュメントのモデル保存の説明も確認してみてください。
よくあるつまずきと対処
| 症状 | 原因と対処 |
|---|---|
GridSearchCVで Invalid parameter エラー |
ステップ名が違うか、アンダースコアが1つになっている。clf.get_params().keys() で正しい名前を確認する |
予測時に Found unknown categories エラー |
OneHotEncoder の handle_unknown が既定の "error" のまま。"ignore" にする |
文字の列で could not convert string to float |
カテゴリ列を数値用の処理(StandardScaler や strategy="median")に渡している。ColumnTransformer の列リストを見直す |
| 交差検証の点数が良すぎる | Pipelineの外で前処理・特徴量選択をしていないか確認する |
まとめ
今回は、scikit-learnのPipelineとColumnTransformerで前処理をまとめる方法を見てきました。要点を振り返ります。
- 手作業の前処理(
get_dummiesなど)は、新しいデータで列がずれてエラーになりやすい ColumnTransformerで列ごとに前処理を振り分け、Pipelineでモデルとつなぐと、fit/predictだけで同じ前処理がかかるhandle_unknown="ignore"で、学習時に無かったカテゴリにも対応できる- データを見て何かを覚える処理をPipelineの外でやるとデータリークが起き、デタラメなデータでも正解率85%のような「盛られた」結果が出る
- GridSearchCVは
ステップ名__パラメータ名で探索でき、joblibで前処理ごと保存できる
Pipelineは最初こそ書き方がむずかしそうに見えますが、一度テンプレートを作ってしまえば、次のデータからは列名を入れ替えるだけで使い回せます。「むずかしそう」を「できそう」に変える第一歩として、ぜひ手元のデータで試してみてください😊
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR