scikit-learnの決定木入門!判定ルールを図で見える化して過学習を交差検証で防ぐ方法
「機械学習のモデルって、なぜその答えを出したのか分からなくてモヤモヤする…」「正解率は高いのに、本番で使うと全然当たらない」
機械学習を触り始めると、こういう悩みにぶつかりますよね。
そこでおすすめなのが決定木(けっていぎ)です。決定木は「どんな質問をして、どう判定したか」を図やテキストでそのまま見られる、数少ないモデルのひとつです。
この記事では、scikit-learn に入っているワインのデータを使って、
- 決定木で品種を当てるモデルを作る
- 判定ルールを図(plot_tree)とテキスト(export_text)で見える化する
- 「学習データだけ100点」の過学習を見抜き、交差検証で木の深さを選ぶ
までを、実際の実行結果つきで一緒に見ていきましょう!
難易度:初級〜中級(Pythonの基本文法が分かり、scikit-learn は初めて〜少し触ったことがある方向け)。
決定木とは?「はい・いいえ」で絞り込むフローチャート
イメージとしては、「はい・いいえ」で答える質問を繰り返して答えを絞り込む、20の質問ゲームです。
たとえば「プロリン(ワインの成分)は765以下?」→「はい」→「フラバノイドは1.4以下?」→「はい」→「品種C!」という具合に、質問の分かれ道をたどって答えにたどり着きます。
つまり決定木は、データから「どの成分を、どの値で区切って質問すれば一番うまく分けられるか」を自動で見つけてくれる仕組みです。ポイントをまとめるとこんな感じです👇
- 判定の理由を人が読める(上司やお客さんに説明しやすい)
- 数値の大きさをそろえる標準化が基本的にいらない(「○○以下か?」と比べるだけなので)
- そのかわり、深く育てすぎると学習データを丸暗記してしまう(過学習)
最後の弱点が、この記事の後半のテーマです。
準備:ライブラリのインストール
scikit-learn と、図を描くための matplotlib を入れておきましょう。
pip install scikit-learn matplotlib今回の動作確認は Python 3.13・scikit-learn 1.9.0・matplotlib 3.11.0(Windows)で行いました。
使うデータは scikit-learn に最初から入っているワインのデータセット(load_wine)です。イタリアの同じ地域で造られた3つの品種のワイン178本について、アルコール度数やプロリンなど13種類の成分を測ったデータで、ダウンロードなしですぐ使えます。
ステップ1:決定木で品種を当ててみる
まずは何も設定せずに決定木を作り、正解率を見てみます。ここが重要です👇
train_test_splitで学習用70%・テスト用30%に分ける(テスト用は「本番の未知のデータ」の代わり)stratify=yで、学習用とテスト用の品種の割合をそろえるrandom_state=0を付けると、何度実行しても同じ結果になる
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

# ワインのデータ(178本・13種類の成分・3つの品種)を読み込む
wine = load_wine()
X, y = wine.data, wine.target
print("データの形:", X.shape)
print("品種の名前:", wine.target_names.tolist())

# 学習用70%・テスト用30%に分ける(品種の割合はそろえる)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0, stratify=y
)

# 決定木を作って学習(深さの制限なし)
model = DecisionTreeClassifier(random_state=0)
model.fit(X_train, y_train)

print("木の深さ:", model.get_depth(), "/ 葉の数:", model.get_n_leaves())
print(f"学習データの正解率: {model.score(X_train, y_train):.3f}")
print(f"テストデータの正解率: {model.score(X_test, y_test):.3f}")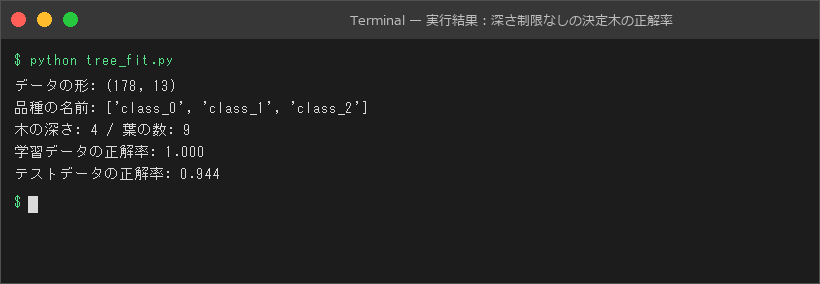
実行結果はこうなりました。
学習データは1.000(100点満点)、テストデータは0.944です。テストの54本中51本を当てているので、なかなかの成績ですよね😊
でも、ちょっと待ってください。学習データで100点というのは、裏を返すと「学習データの細かいクセまで全部覚えた」ということでもあります。これが本当に良いことなのかは、ステップ4で確かめます。
ステップ2:判定ルールを図にする(plot_tree)
決定木のいちばんの魅力、「中身を見る」をやってみましょう。深さ制限なしの木は図が大きくなるので、ここではmax_depth=2(質問は最大2回)に制限した木を描きます。
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree

plt.rcParams["font.family"] = "Meiryo"  # Windowsで日本語を表示する(Macなら "Hiragino Sans")

wine = load_wine()
X_train, X_test, y_train, y_test = train_test_split(
    wine.data, wine.target, test_size=0.3, random_state=0, stratify=wine.target
)

# 図を読みやすくするため、深さを2に制限した木を作る
model = DecisionTreeClassifier(max_depth=2, random_state=0)
model.fit(X_train, y_train)

plt.figure(figsize=(12, 6))
plot_tree(
    model,
    feature_names=wine.feature_names,    # 質問に使う成分の名前
    class_names=["品種A", "品種B", "品種C"],  # class_0〜2 に日本語名をつける
    filled=True,                         # 多数派の品種で色分け
    rounded=True,
    fontsize=11,
)
plt.title("ワインの品種を当てる決定木(深さ2)")
plt.show()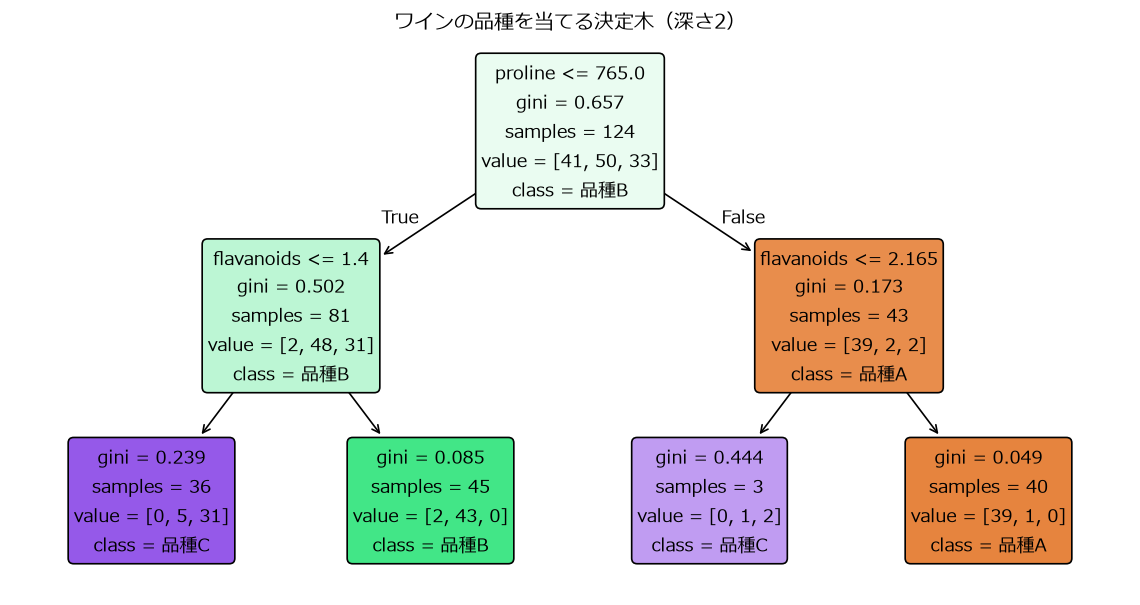
実行すると、次のような図が表示されます。
図の読み方はこんな感じです👇
- 1行目の
proline <= 765.0が質問。当てはまれば左(True)、当てはまらなければ右(False)へ進む - samples:その箱にたどり着いた学習データの本数(最初は124本)
- value:その中の品種ごとの本数。
[41, 50, 33]なら品種A・B・Cの順 - class:その箱での多数派=この箱に来たら出す答え
- gini:品種の「混ざり具合」。0に近いほど1つの品種にそろっている
右下の箱を見ると value = [39, 1, 0] で、40本中39本が品種Aです。つまり「プロリンが765より多くて、フラバノイドが2.165より多ければ、ほぼ品種A」というルールを、モデルが自分で見つけたわけです。
一方で、右から2番目の箱は samples = 3 とたった3本しかありません。「3本だけのために作られた分かれ道」は、たまたまのクセを覚えている可能性があります。このあたりが過学習の入り口です⚠️
ステップ3:ルールをテキストで出す・重要度と確率を見る
図はきれいですが、ルールをメモに残したり、Excelの条件式に書き写したりしたいときはテキストのほうが便利です。あわせて、「どの成分が効いているか」と「予測の自信の度合い」も見てみましょう。
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, export_text

wine = load_wine()
X_train, X_test, y_train, y_test = train_test_split(
    wine.data, wine.target, test_size=0.3, random_state=0, stratify=wine.target
)
model = DecisionTreeClassifier(max_depth=2, random_state=0)
model.fit(X_train, y_train)
names = ["品種A", "品種B", "品種C"]

# ① 判定ルールをテキストで表示する
print(export_text(model, feature_names=wine.feature_names, class_names=names))

# ② どの成分が判定に効いているか(特徴量の重要度)
print("--- 重要度(0より大きいものだけ)---")
for name, imp in sorted(zip(wine.feature_names, model.feature_importances_),
                        key=lambda t: t[1], reverse=True):
    if imp > 0:
        print(f"{name:12} {imp:.3f}")

# ③ テストデータの先頭1本を予測して、確率も見る
sample = X_test[:1]
pred = model.predict(sample)[0]
proba = model.predict_proba(sample)[0]
print("--- 予測 ---")
print(f"proline={sample[0][12]:.0f}, flavanoids={sample[0][6]:.2f}")
print("予測:", names[pred], "/ 正解:", names[y_test[0]])
print("確率:", {n: round(float(p), 3) for n, p in zip(names, proba)})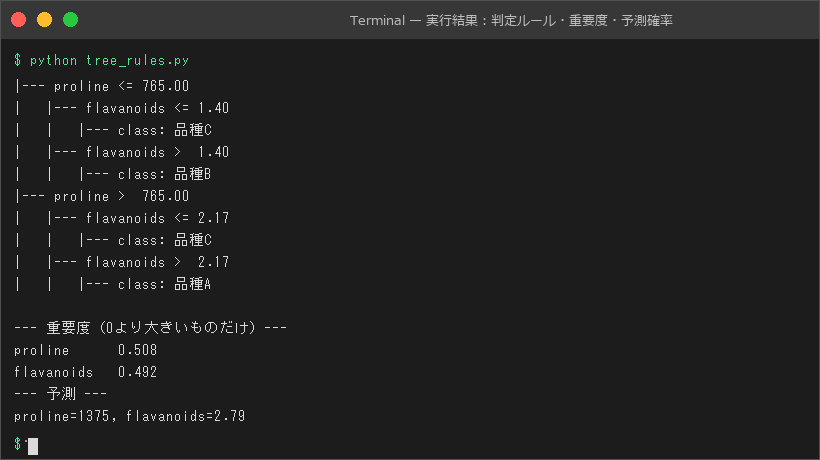
実行結果はこちらです。
ポイントをまとめるとこんな感じです👇
- export_text:図と同じルールが、インデント付きのテキストで出る。しきい値は小数第2位までに丸められるので、図の 2.165 が 2.17 と表示されています
- feature_importances_:13成分のうち、この木が使ったのはproline と flavanoids の2つだけ。重要度はほぼ半々でした
- predict_proba:たどり着いた箱の品種の割合がそのまま「確率」になる。今回は
[39, 1, 0]の箱なので、39÷40=0.975
これ、実行せずに答えられますか?「proline=1375・flavanoids=2.79 のワインはどの品種?」……図をたどれば、1375は765より大きいので右へ、2.79は2.165より大きいので右へ、で品種A。モデルの答えと同じ道筋を、人間もたどれるのが決定木の強みです。
⚠️ ひとつ注意として、重要度が0の成分は「役に立たない成分」という意味ではありません。「この木では質問に使われなかった」だけです。似た情報を持つ別の成分が先に選ばれると、もう片方は0になることがあります。
ステップ4:過学習を見抜いて、木の深さを決める
いよいよ本題です。ステップ1の「学習データ100点」は良いことなのでしょうか?
過学習とは、イメージとしては「問題集の答えを丸暗記して、問題集では100点なのに、本番の初見問題には弱い」状態です。これを確かめるには、解いたことのない問題での成績と比べるのが一番です。
そこで使うのが交差検証(クロスバリデーション)です。学習データを5つに分け、「4つで学習→残り1つでテスト」を担当を替えながら5回繰り返して、その平均を取ります。cross_val_score を使えば1行で書けます。
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.tree import DecisionTreeClassifier

plt.rcParams["font.family"] = "Meiryo"

wine = load_wine()
X_train, X_test, y_train, y_test = train_test_split(
    wine.data, wine.target, test_size=0.3, random_state=0, stratify=wine.target
)

depths = range(1, 7)
train_scores, cv_scores = [], []
print("深さ  学習データ  交差検証(5分割)")
for d in depths:
    model = DecisionTreeClassifier(max_depth=d, random_state=0)
    # 学習データだけを5つに分けて「解いたことのない問題」の正解率を測る
    cv = cross_val_score(model, X_train, y_train, cv=5).mean()
    model.fit(X_train, y_train)
    train_scores.append(model.score(X_train, y_train))
    cv_scores.append(cv)
    print(f"{d:>3}   {train_scores[-1]:.3f}       {cv:.3f}")

best = depths[cv_scores.index(max(cv_scores))]
print("交差検証で一番よい深さ:", best)

# 選んだ深さで作り直し、最後に1回だけテストデータで確認する
final = DecisionTreeClassifier(max_depth=best, random_state=0).fit(X_train, y_train)
print(f"テストデータの正解率: {final.score(X_test, y_test):.3f}")

plt.plot(depths, train_scores, marker="o", label="学習データ")
plt.plot(depths, cv_scores, marker="s", label="交差検証")
plt.xlabel("木の深さ(max_depth)")
plt.ylabel("正解率")
plt.title("深くするほど学習データには強くなるが…")
plt.legend()
plt.grid(alpha=0.3)
plt.show()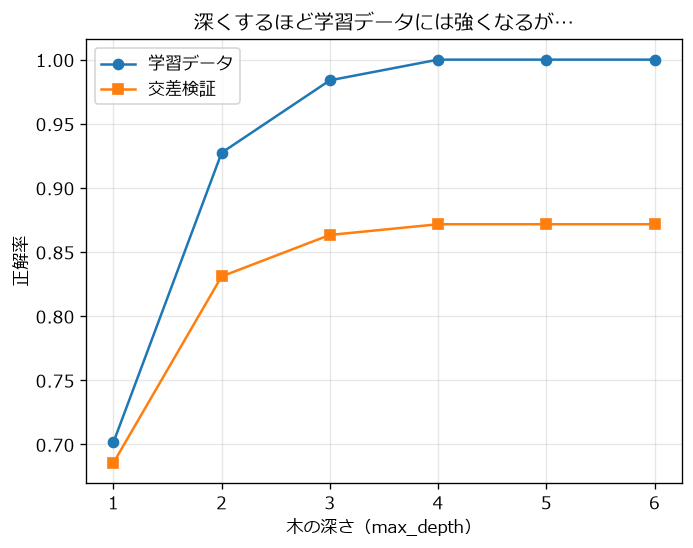
実行結果(表の部分)はこうなりました。
| 深さ | 学習データ | 交差検証(5分割) |
|---|---|---|
| 1 | 0.702 | 0.686 |
| 2 | 0.927 | 0.831 |
| 3 | 0.984 | 0.863 |
| 4 | 1.000 | 0.872 |
| 5 | 1.000 | 0.872 |
| 6 | 1.000 | 0.872 |
そのあとに「交差検証で一番よい深さ: 4」「テストデータの正解率: 0.944」と表示されます。グラフにするとこうです。
ここから読み取れることは3つです👇
- 学習データと交差検証の差が大きい:深さ4以上では学習データ1.000に対して交差検証0.872。この約0.13の差が「丸暗記ぶん」で、過学習のサインです
- 深さ4から先は変わらない:このデータでは深さ4の時点で学習データを全部当て切ってしまい、それ以上質問を増やす必要がないので、木がそれ以上育ちません(ステップ1の「木の深さ: 4」と同じ理由です)
- 深さ3と4の差はわずか:交差検証で0.863と0.872、差は0.01ほど。葉の数は深さ3で8個、深さ4で9個です。説明のしやすさを優先して、あえて浅い深さ3を選ぶのも十分ありです
つまずきポイント:テストデータで深さを選ばない
実は、テストデータの正解率を深さごとに測ると、深さ3が0.963、深さ4が0.944で、交差検証とは逆に深さ3のほうが高くなります。
「じゃあテストデータで一番よい深さを選べばいいのでは?」と思いますよね。でもこれは避けたほうが安全です。テストデータは54本しかないので、1本当たるかどうかで約0.02も動きます。そこで一番よい値を選ぶと、「たまたまこの54本と相性がよかった設定」を選んでしまい、本番の成績を正しく見積もれなくなります。
だからこのコードでは、
- 深さ選びは学習データの中の交差検証だけで行う
- 決めた設定で作り直したモデルを、最後に1回だけテストデータで確認する
という順番にしています。この「テストデータは最後まで取っておく」習慣は、決定木に限らずどの機械学習モデルでも大事です。
深さ以外の「育ちすぎ防止」パラメータ
木の育ちすぎを抑える方法は max_depth だけではありません。よく使うものをまとめておきます。
| パラメータ | 意味 | イメージ |
|---|---|---|
max_depth |
質問の回数の上限 | 分かれ道は最大○段まで |
min_samples_leaf |
1つの葉に残すデータの最低数 | 「3本だけの箱」を作らせない |
min_samples_split |
分割してよい箱のデータの最低数 | 少なすぎる箱はもう分けない |
ccp_alpha |
育てた木を後から刈り込む強さ | 効果の薄い枝を剪定する |
まずは max_depth を交差検証で選ぶ、という今回の方法から始めるのがおすすめです。慣れてきたら GridSearchCV を使うと、複数のパラメータの組み合わせをまとめて交差検証で比べられます。
詳しい引数は公式ドキュメント(scikit-learn: Decision Trees)にまとまっています。
まとめ
今回は scikit-learn の決定木で、ワインの品種を当てるモデルを作りながら、中身の見える化と過学習の見抜き方を見てきました。ポイントをおさらいしましょう。
- 決定木は「はい・いいえ」の質問で答えを絞り込むモデル。判定の理由を人が読める
plot_treeで図、export_textでテキストとしてルールを出せる。predict_probaの確率は「たどり着いた箱の品種の割合」- 学習データで100点でも安心しない。学習データと交差検証の差が大きければ過学習のサイン
- 深さなどの設定は交差検証で選び、テストデータは最後に1回だけ使う
「なぜその答えになったのか」が見えると、機械学習がぐっと身近に感じられるはずです。ワインのデータで流れがつかめたら、手元のCSVでもぜひ試してみてください🚀
こちらも読まれています
📚 関連商品・おすすめ書籍
※本記事にはアフィリエイトリンクが含まれます。
PR